Dokumentasi
Penyiapan Server
Input suara mengubah ucapan menjadi masukan terminal: bicara alih-alih mengetik, dengan polesan LLM opsional untuk transkrip sebelum dikirim. Pengenalan berjalan sebagai server ASR lokal dengan model di perangkat — audio dan teks tetap di mesin Anda. Halaman ini membahas sisi server; pengalaman desktop ada di Menggunakan Klien.
Kartu Local ASR Server
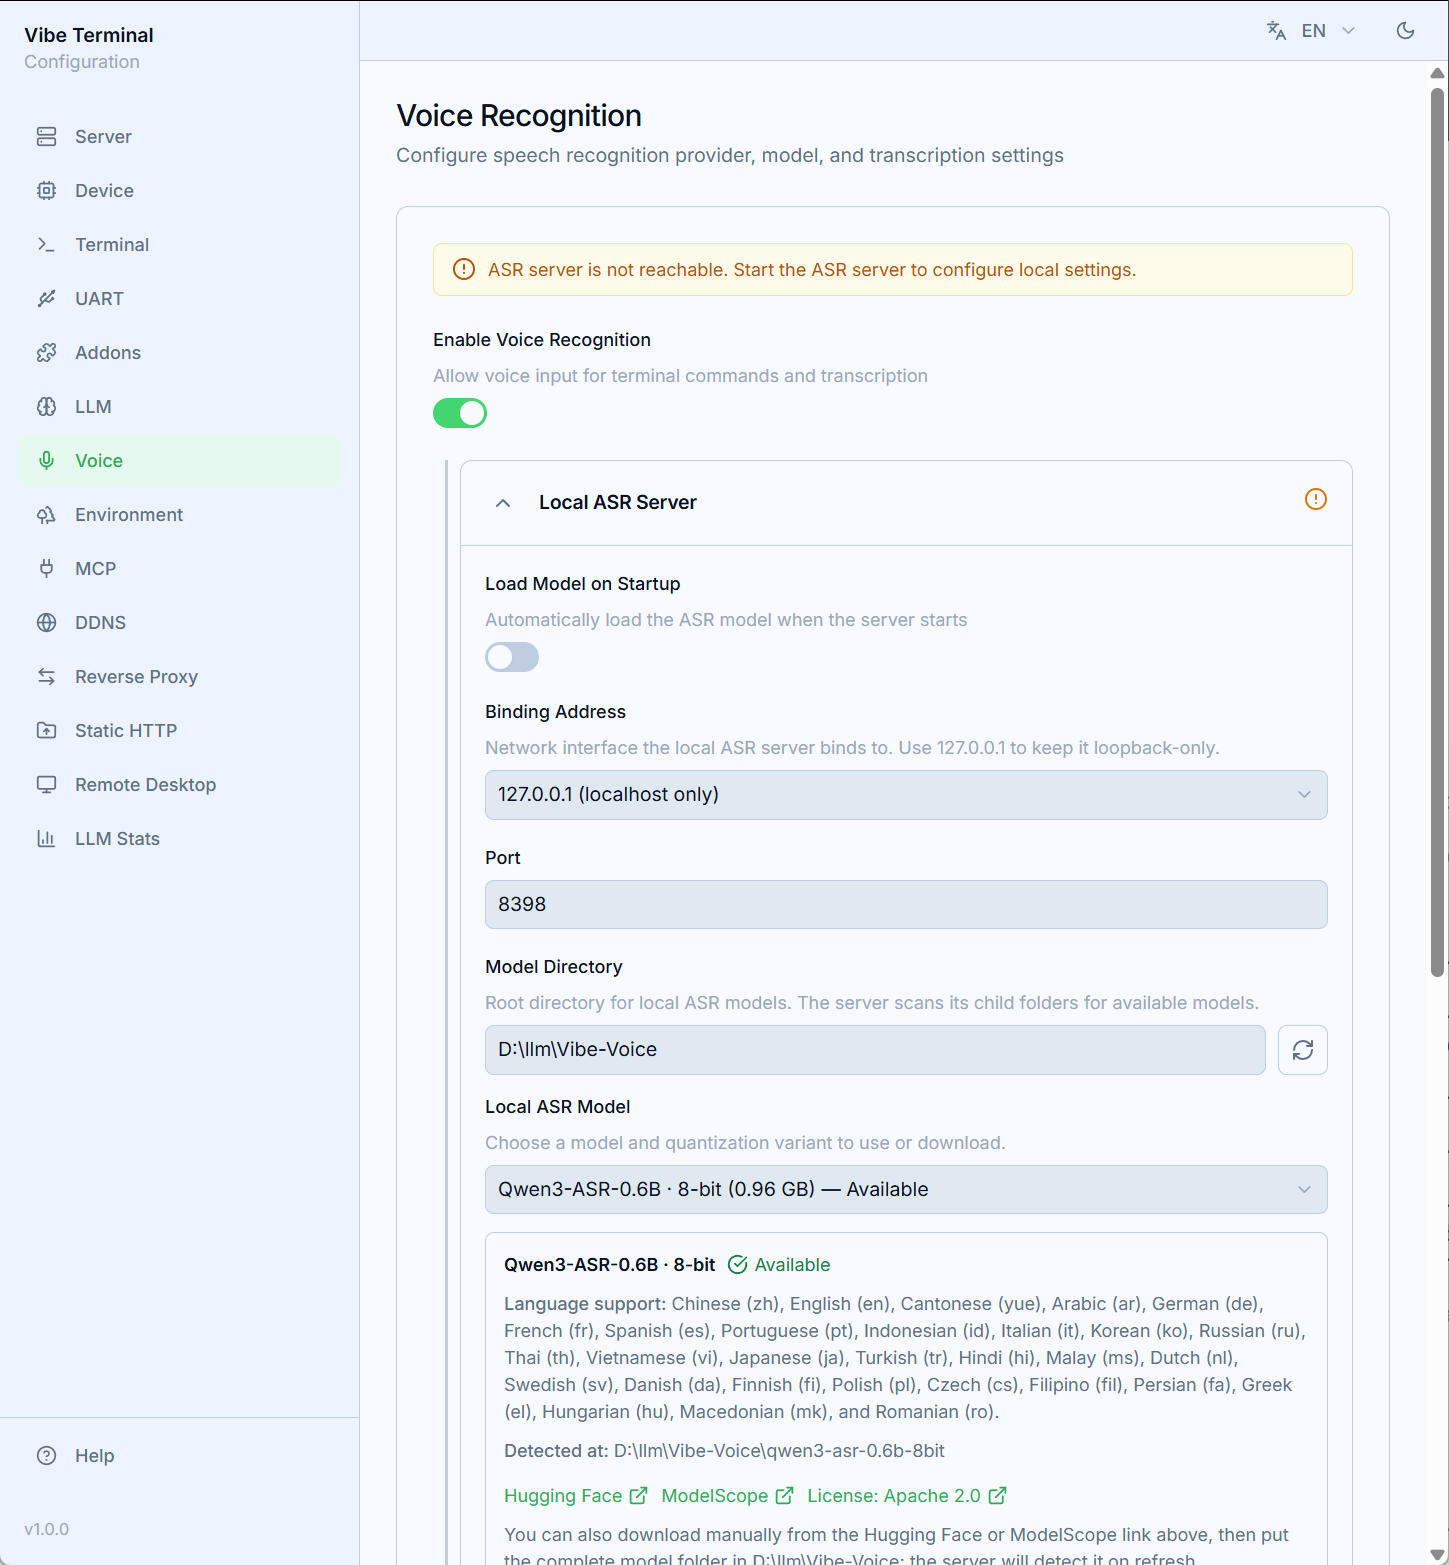
Buka bagian Voice Web UI dan aktifkan pengenalan suara. Kartu Local ASR Server mengelola proses vterm-voice yang diawasi:
Load on Startup— memulai server ASR bersama backend;Bind Address(127.0.0.1hanya localhost /0.0.0.0semua antarmuka) danPort(bawaan8398) — tempat endpoint ASR mendengarkan;Model Directory+Local Model— pilih dari katalog bawaan: keluarga Qwen3-ASR, Fun-ASR, dan Parakeet, masing-masing dalam varian full / 8-bit / 4-bit.Downloadmengambil model dari Hugging Face atau ModelScope ke direktori dengan bilah kemajuan langsung; perintahgit clonemanual ditampilkan sebagai cadangan, dan model yang sudah di disk ditandai tersedia;Device— backend inferensi (Auto,CPU,CUDA,Vulkan,Metal), sebagaimana dilaporkan server;Access Token— rahasia bersama untuk endpoint; tombol dadu membuat satu;Savemenyimpan kartu (suntingan tetap draf lokal sampai itu), danStart Server/Stop Servermengendalikan prosesnya. Ikon status di judul kartu mencerminkan keterjangkauan dan status model (termuat / memuat / galat).
Persaingan CUDA: ketika program inferensi CUDA lain sudah menempati GPU (mis. llama.cpp menjalankan model lokal), membiarkan vterm-voice juga memakai
CUDAdapat memperlambat keduanya drastis. Dalam kasus itu aturDevicekeCPU— model ASR ringkas ini cukup cepat di CPU.
Penyedia dan pengujian
Dropdown penyedia mendaftar addon ASR — addon vibe-voice bawaan menunjuk ke server terawasi ini, jadi memilihnya adalah cara panel memakai model lokal Anda.
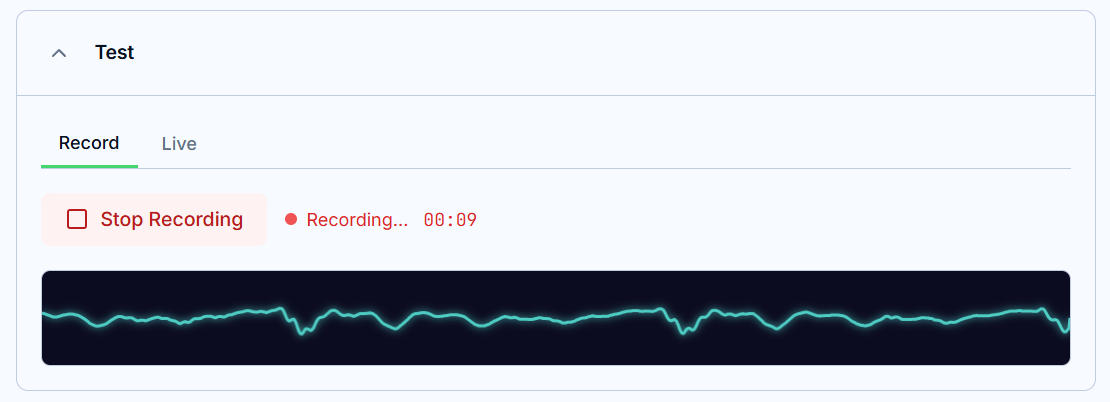
Area Test mencoba semuanya tanpa klien: Record (mikrofon → gelombang → transkripsi) dan Live (pengenalan mengalir), masing-masing dengan waktu dan tombol salin.