Dokumentacja
Konfiguracja serwera
Wprowadzanie głosowe zamienia mowę na wejście terminala: mów zamiast pisać, z opcjonalnym szlifem LLM transkrypcji przed wysłaniem. Rozpoznawanie działa jako lokalny serwer ASR z modelami na urządzeniu — audio i tekst zostają na Twojej maszynie. Ta strona obejmuje stronę serwera; doświadczenie desktopowe mieszka w Korzystaniu z klienta.
Karta Local ASR Server
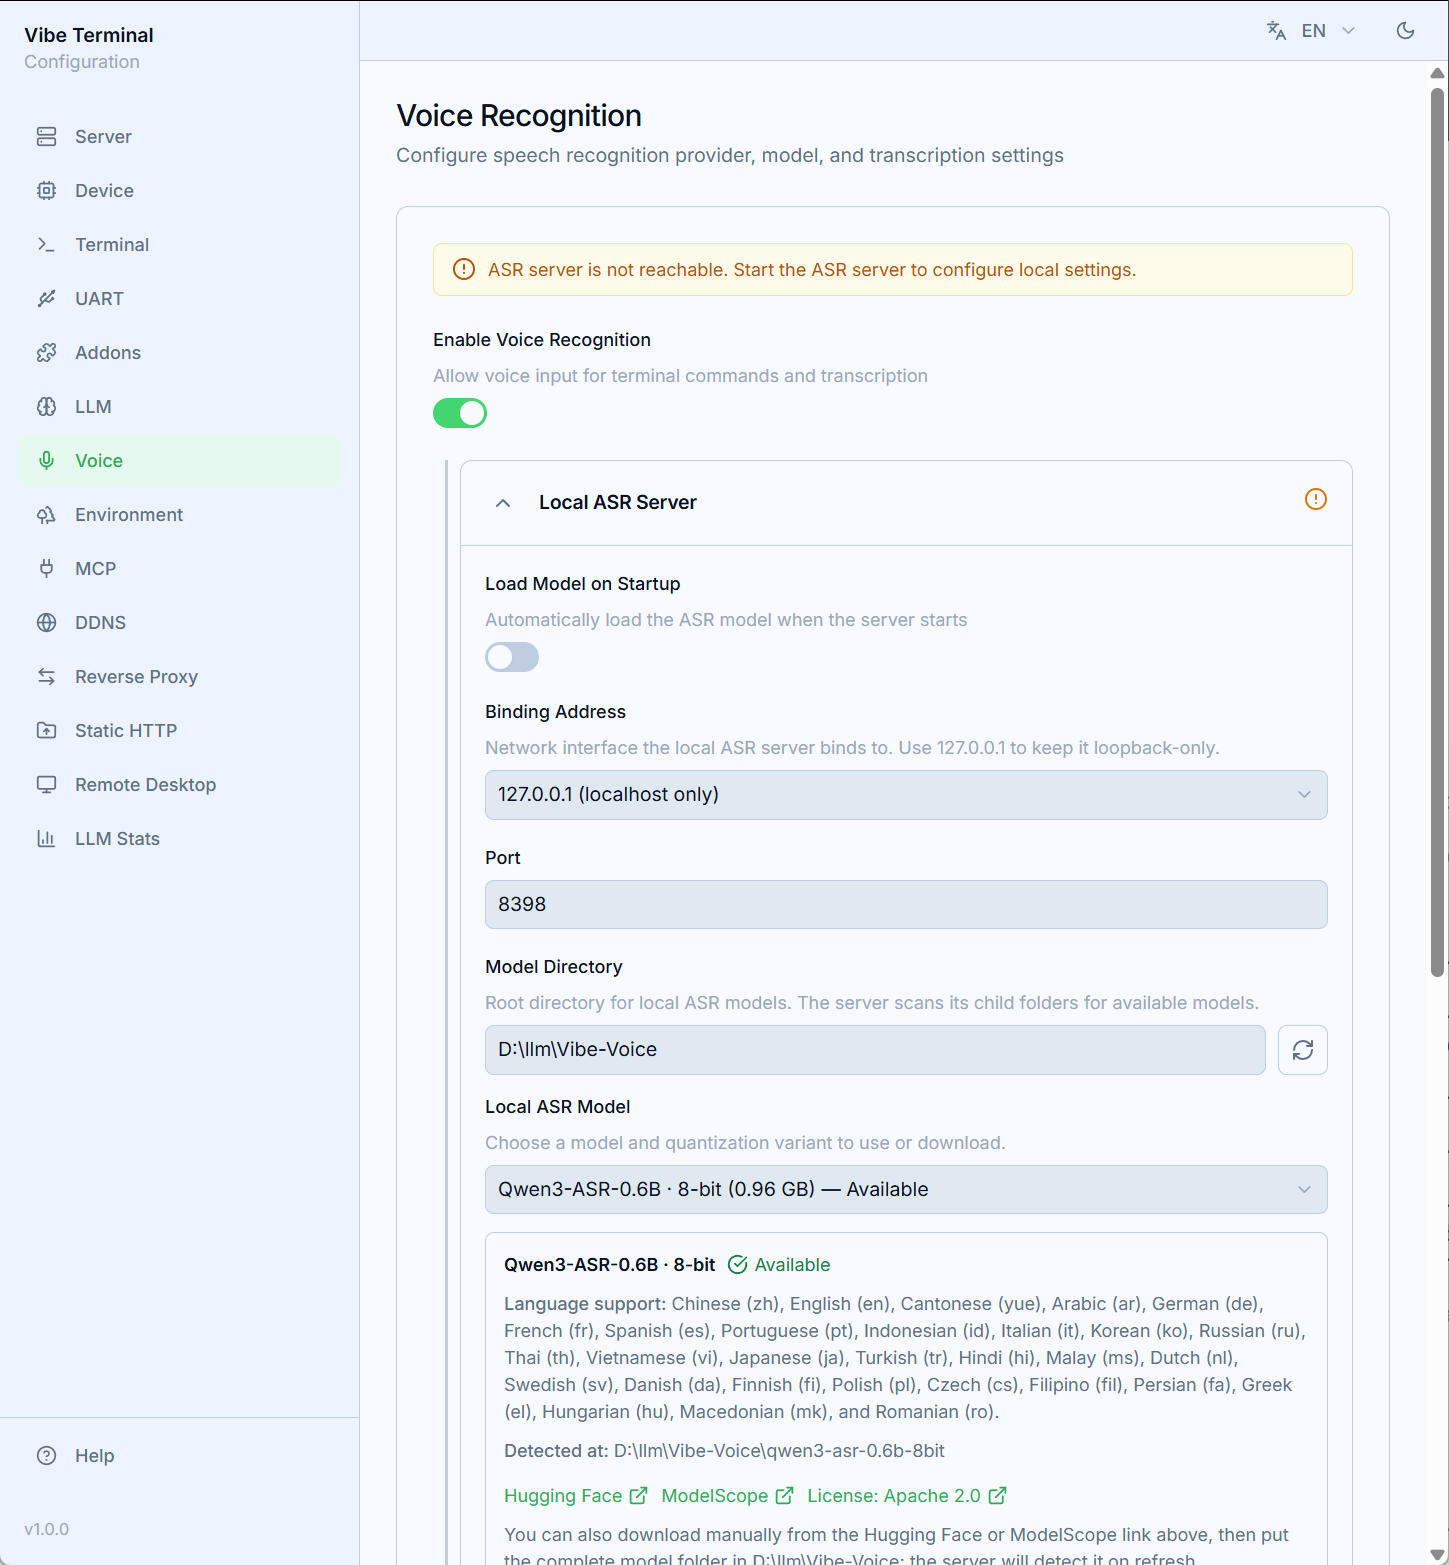
Otwórz sekcję Voice Web UI i włącz rozpoznawanie mowy. Karta Local ASR Server zarządza nadzorowanym procesem vterm-voice:
Load on Startup— uruchomienie serwera ASR razem z backendem;Bind Address(127.0.0.1tylko localhost /0.0.0.0wszystkie interfejsy) iPort(domyślnie8398) — gdzie nasłuchuje punkt ASR;Model Directory+Local Model— wybór z wbudowanego katalogu: rodziny Qwen3-ASR, Fun-ASR i Parakeet, każda w wariantach full / 8-bit / 4-bit.Downloadsprowadza model z Hugging Face albo ModelScope do katalogu z paskiem postępu na żywo; ręczne komendygit clonesą pokazane jako plan B, a modele już na dysku są oznaczone jako dostępne;Device— backend wnioskowania (Auto,CPU,CUDA,Vulkan,Metal), zgodnie z raportem serwera;Access Token— wspólny sekret punktu; przycisk kostki go generuje;Saveutrwala kartę (edycje są do tego czasu lokalnym szkicem), aStart Server/Stop Serversterują procesem. Ikona statusu w tytule karty odzwierciedla osiągalność i stan modelu (wczytany / wczytuje / błąd).
Kolizja CUDA: gdy inny program wnioskowania CUDA już zajmuje GPU (np. llama.cpp z lokalnym modelem), pozwolenie vterm-voice też na
CUDAmoże drastycznie spowolnić jedno i drugie. Wtedy ustawDevicenaCPU— te kompaktowe modele ASR są na CPU wystarczająco szybkie.
Dostawca i testy
Rozwijana lista dostawców wypisuje dodatki ASR — wbudowany dodatek vibe-voice wskazuje ten nadzorowany serwer, więc jego wybór to sposób, by panel używał Twoich lokalnych modeli.
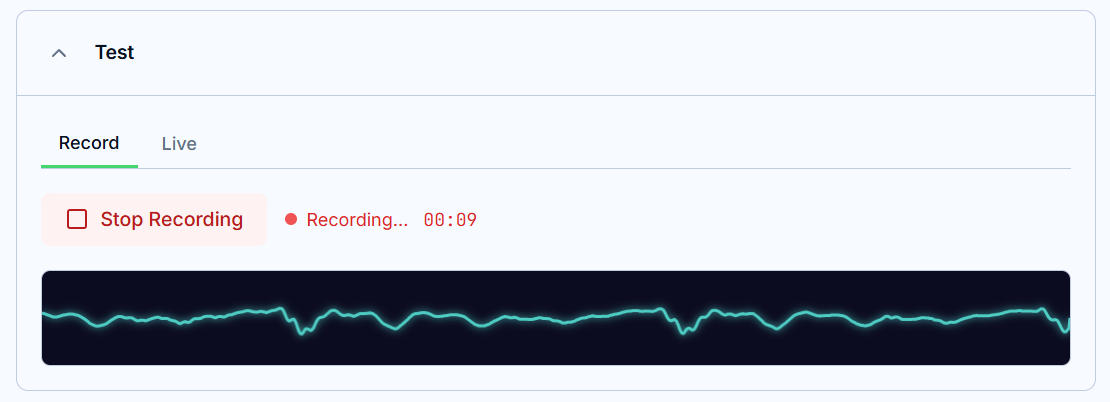
Obszar Test próbuje wszystkiego bez klienta: Record (mikrofon → fala → transkrypcja) i Live (rozpoznawanie strumieniowe), każde z czasami i przyciskiem kopiowania.