Документация
Настройка сервера
Голосовой ввод превращает речь в ввод терминала: говорите вместо печати, с опциональной LLM-полировкой транскрипции перед отправкой. Распознавание работает как локальный ASR-сервер с моделями на устройстве — аудио и текст остаются на вашей машине. Эта страница покрывает серверную сторону; десктоп-опыт — в Работе с клиентом.
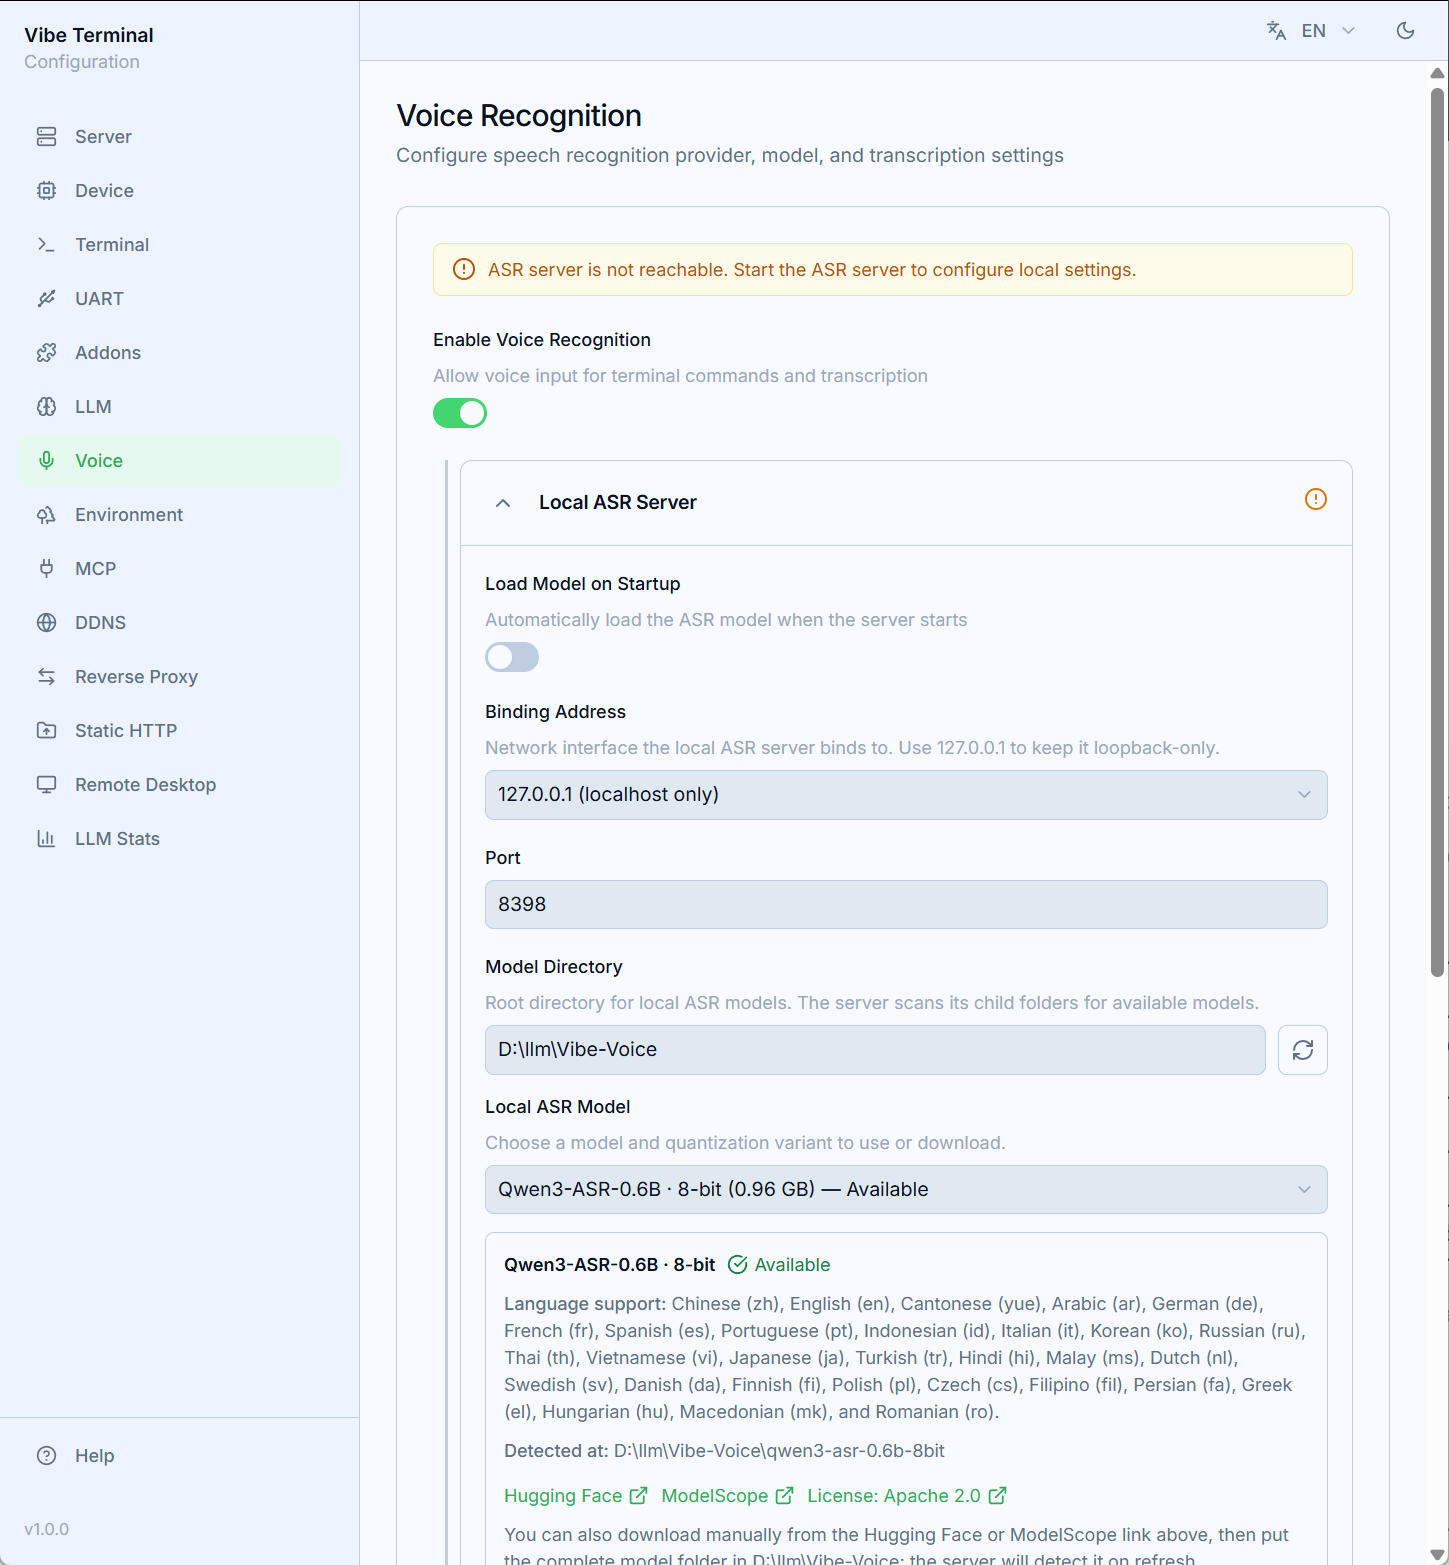
Карточка Local ASR Server
Откройте раздел Voice веб-интерфейса и включите распознавание речи. Карточка Local ASR Server управляет supervised-процессом vterm-voice:
Load on Startup— запускать ASR-сервер вместе с бэкендом;Bind Address(127.0.0.1только localhost /0.0.0.0все интерфейсы) иPort(по умолчанию8398) — где слушает ASR-эндпоинт;Model Directory+Local Model— выберите из встроенного каталога: семейства Qwen3-ASR, Fun-ASR и Parakeet, каждое в вариантах full / 8 бит / 4 бита.Downloadзабирает модель с Hugging Face или ModelScope в каталог с живым индикатором прогресса; ручные командыgit cloneпоказываются как запасной путь, а модели уже на диске помечаются доступными;Device— бэкенд вывода (Auto,CPU,CUDA,Vulkan,Metal), как сообщает сервер;Access Token— общий секрет эндпоинта; кнопка с кубиком генерирует его;Saveсохраняет карточку (правки до этого — локальный черновик), аStart Server/Stop Serverуправляют процессом. Значок статуса в заголовке карточки отражает достижимость и состояние модели (загружена / загружается / ошибка).
Конфликт CUDA: когда другая CUDA-программа вывода уже занимает GPU (напр. llama.cpp с локальной моделью), разрешение vterm-voice тоже использовать
CUDAможет резко замедлить обе. В этом случае поставьтеDeviceнаCPU— эти компактные ASR-модели достаточно быстры на CPU.
Провайдер и тестирование
Выпадающий список провайдеров перечисляет ASR-аддоны — встроенный аддон vibe-voice указывает на этот supervised-сервер, поэтому его выбор — способ заставить панель использовать ваши локальные модели.
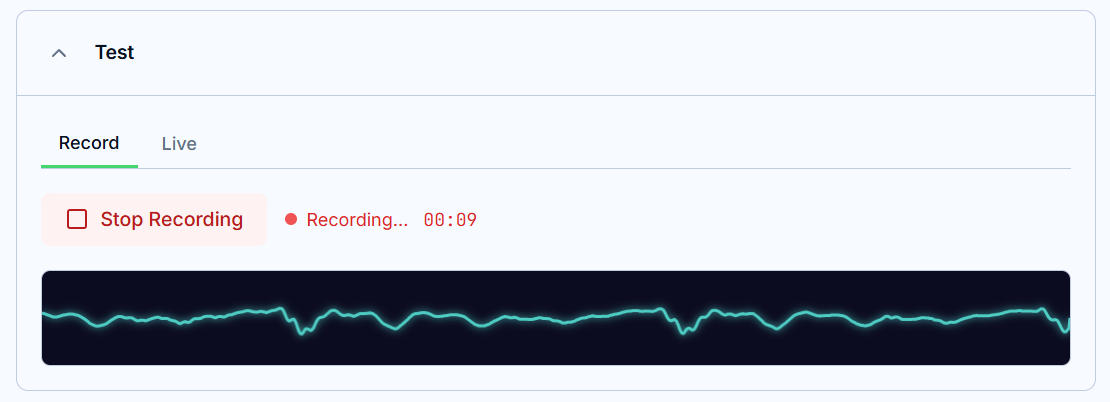
Область Test пробует всё без клиента: Record (микрофон → волновая форма → транскрипция) и Live (потоковое распознавание), каждая со временем и кнопкой копирования.