문서
서버 설정
음성 입력은 말을 터미널 입력으로 바꿉니다. 타이핑 대신 말하고, 보내기 전에 전사에 LLM 다듬기를 선택적으로 적용합니다. 인식은 온기기 모델로 로컬 ASR 서버에서 실행되며 — 오디오와 텍스트는 당신의 머신에 남습니다. 이 페이지는 서버 쪽을 다루고, 데스크톱 경험은 클라이언트 사용법에 있습니다.
Local ASR Server 카드
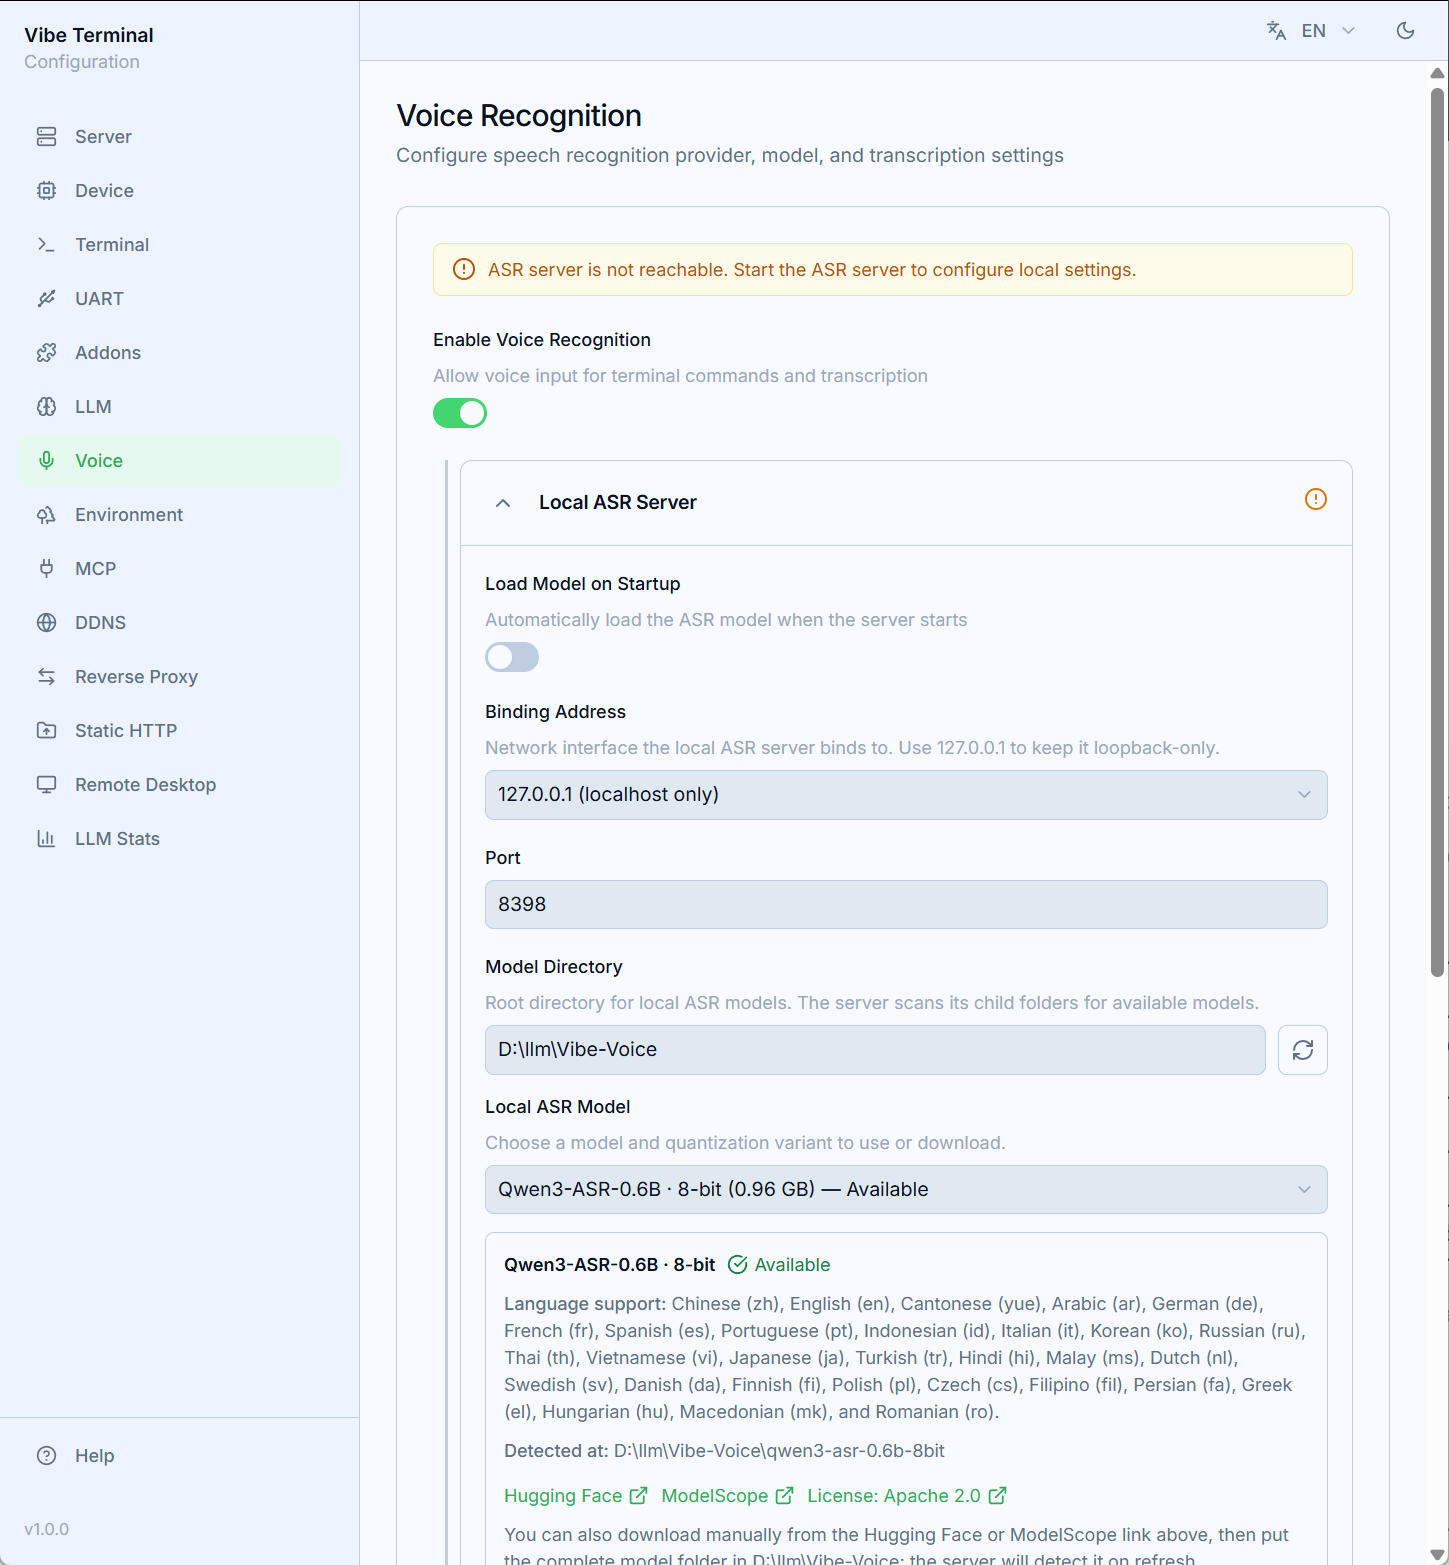
Web UI의 Voice 섹션을 열고 음성 인식을 켭니다. Local ASR Server 카드는 감독되는 vterm-voice 프로세스를 관리합니다:
Load on Startup— 백엔드와 함께 ASR 서버 시작;Bind Address(127.0.0.1로컬 전용 /0.0.0.0모든 인터페이스)와Port(기본8398) — ASR 엔드포인트의 수신 지점;Model Directory+Local Model— 내장 카탈로그에서 고르기: Qwen3-ASR, Fun-ASR, Parakeet 계열, 각각 full / 8-bit / 4-bit 변형.Download는 Hugging Face 또는 ModelScope에서 모델을 디렉터리로 내려받으며 실시간 진행률 표시줄을 보여 줍니다. 폴백으로 수동git clone명령이 표시되고, 이미 디스크에 있는 모델은 사용 가능으로 표시됩니다;Device— 추론 백엔드(Auto,CPU,CUDA,Vulkan,Metal), 서버가 보고하는 대로;Access Token— 엔드포인트의 공유 시크릿. 주사위 버튼으로 생성;Save로 카드를 저장하고(저장까지 편집은 로컬 초안),Start Server/Stop Server로 프로세스를 제어합니다. 카드 제목의 상태 아이콘은 도달 가능성과 모델 상태(로드됨 / 로드 중 / 오류)를 반영합니다.
CUDA 경합: 다른 CUDA 추론 프로그램이 이미 GPU를 점유할 때(llama.cpp로 로컬 모델 실행 중 등), vterm-voice도
CUDA를 쓰게 하면 둘 다 크게 느려질 수 있습니다. 그 경우Device를CPU로 두세요 — 이런 콤팩트한 ASR 모델은 CPU로도 충분히 빠릅니다.
공급자와 테스트
공급자 드롭다운은 ASR 애드온을 나열합니다 — 내장 vibe-voice 애드온이 이 감독 서버를 가리키므로, 이것을 선택하는 것이 패널이 로컬 모델을 쓰게 하는 방법입니다.
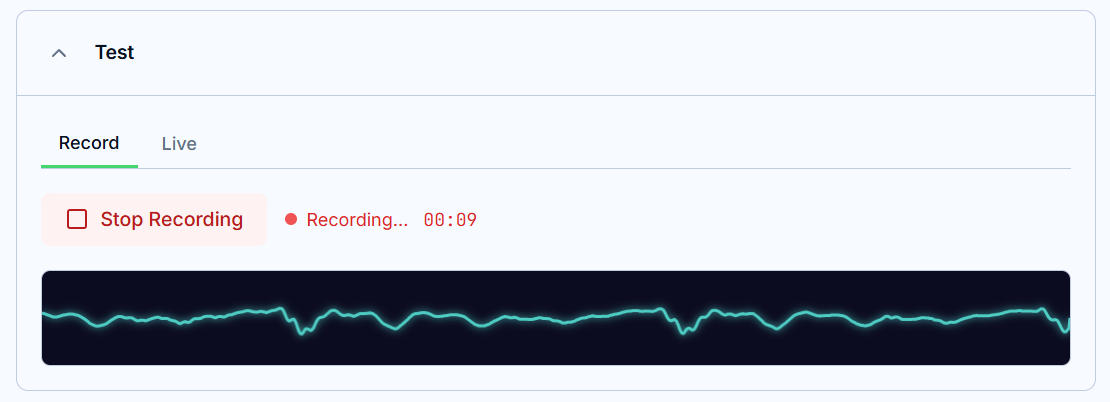
Test 영역은 클라이언트 없이 모두 시도합니다: Record(마이크 → 파형 → 전사)와 Live(스트리밍 인식), 각각 소요 시간과 복사 버튼 포함.