ドキュメント
サーバー設定
音声入力は音声をターミナル入力に変えます。タイピングの代わりに話し、送信前に LLM による録音のポリッシュを任意で適用できます。認識はオンデバイスのモデルでローカル ASR サーバーとして動作し、音声もテキストもマシンから出ません。このページはサーバー側を扱い、デスクトップでの体験はクライアントの使い方にあります。
Local ASR Server カード
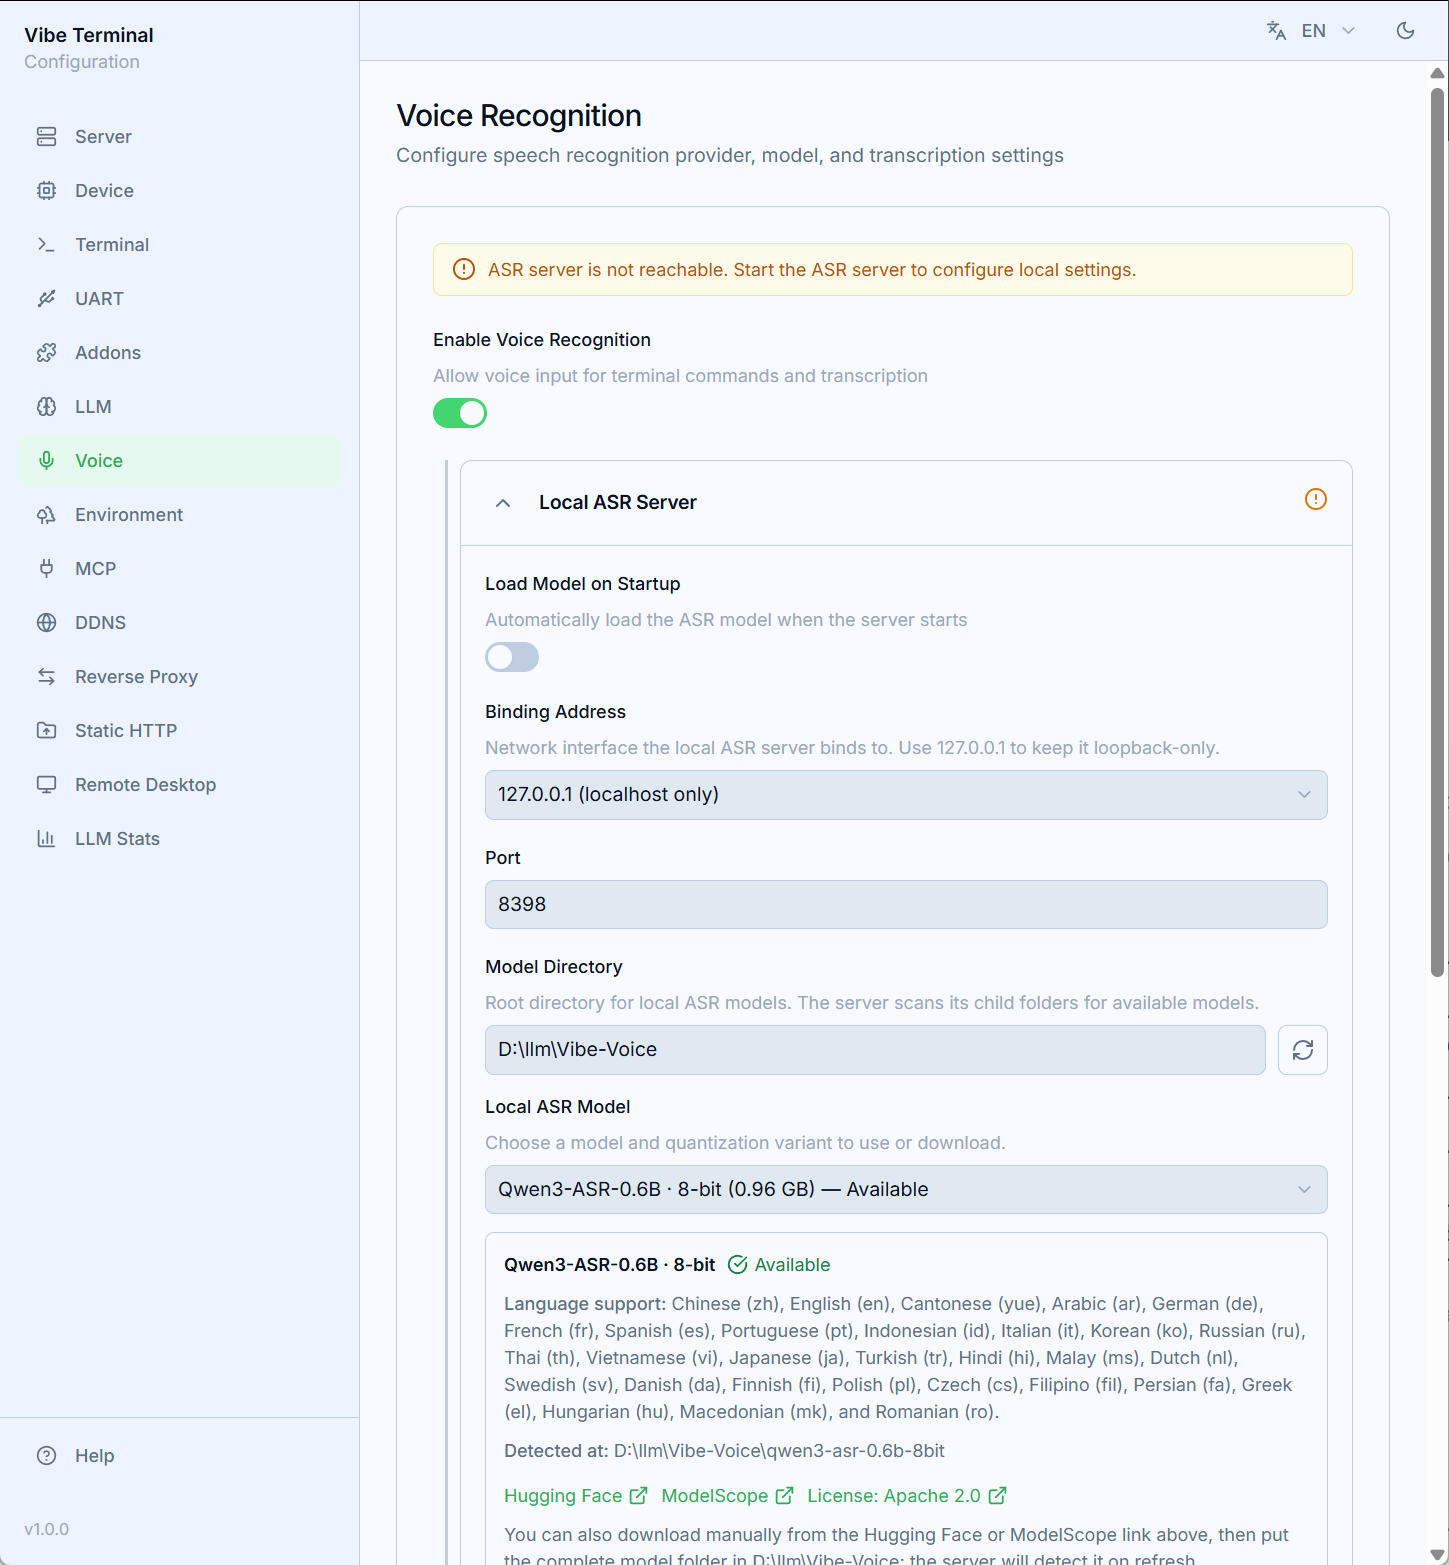
Web UI の Voice セクションを開き、音声認識を有効にします。Local ASR Server カードは監視下の vterm-voice プロセスを管理します:
Load on Startup— バックエンドと一緒に ASR サーバーを起動;Bind Address(127.0.0.1ローカルのみ /0.0.0.0全インターフェース)とPort(デフォルト8398)— ASR エンドポイントのリスン先;Model Directory+Local Model— 内蔵カタログから選択: Qwen3-ASR、Fun-ASR、Parakeet ファミリー、それぞれ full / 8-bit / 4-bit 版。Downloadは Hugging Face または ModelScope からモデルをディレクトリに取得し、ライブの進行状況バーを表示します。フォールバックとして手動git cloneコマンドが表示され、既にディスク上にあるモデルは利用可能とマークされます;Device— 推論バックエンド(Auto、CPU、CUDA、Vulkan、Metal)。サーバーの報告どおり;Access Token— エンドポイントの共有シークレット。ダイスボタンで生成;Saveでカードを保存し(保存まで編集はローカルドラフト)、Start Server/Stop Serverでプロセスを制御します。カードタイトルのステータスアイコンは到達可能性とモデル状態(ロード済み / ロード中 / エラー)を反映します。
CUDA 競合: 別の CUDA 推論プログラムが既に GPU を占有しているとき(llama.cpp でローカルモデルを実行しているなど)、vterm-voice にも
CUDAを使わせると両方が大幅に遅くなることがあります。その場合はDeviceをCPUにしてください — こうしたコンパクトな ASR モデルは CPU でも十分速いです。
プロバイダーとテスト
プロバイダーのドロップダウンには ASR アドオンが一覧表示されます — 内蔵の vibe-voice アドオンはこの監視下サーバーを指すため、これを選ぶのがパネルにローカルモデルを使わせる方法です。
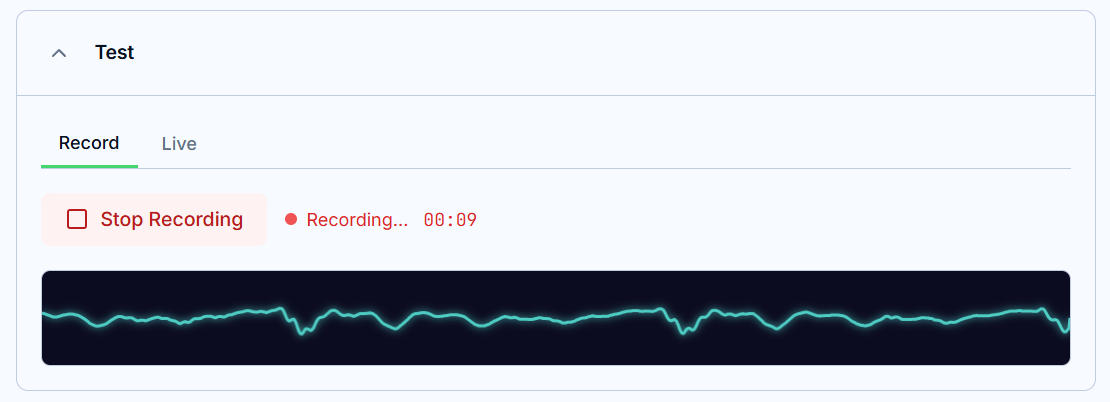
Test エリアはクライアントなしで全部を試せます: Record(マイク → 波形 → 文字起こし)とLive(ストリーミング認識)。それぞれ所要時間とコピーボタン付き。