Documentation
LLM
La section LLM de l’interface Web affecte un fournisseur LLM à chaque fonction IA — classification de terminal, messages de commit Git, résolution de conflits, polissage de texte vocal et traduction. Les fournisseurs eux-mêmes sont des addons de type LLM gérés dans la section Addons.
Les fournisseurs sont des addons
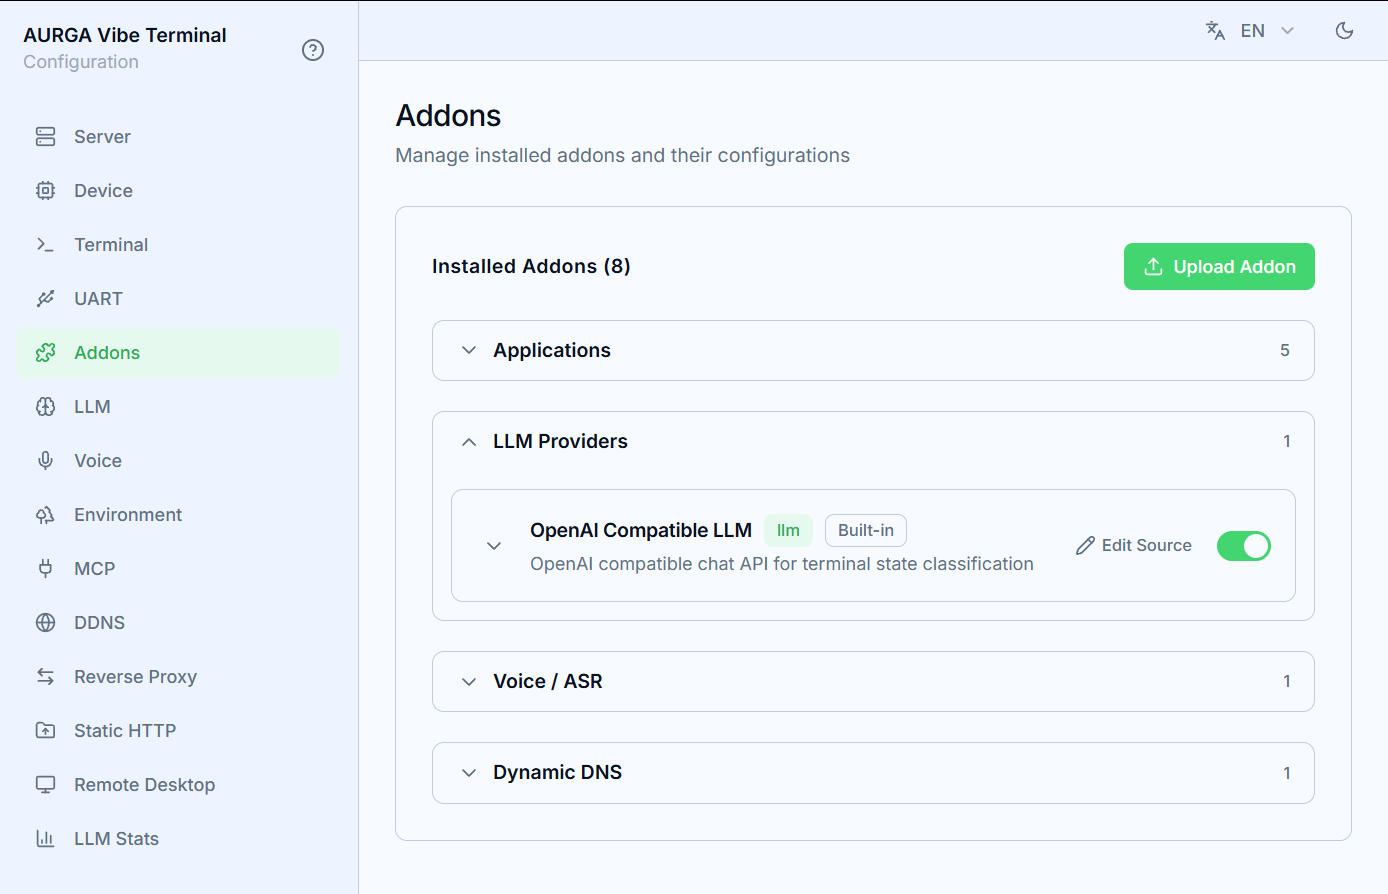
Les fournisseurs LLM vivent dans le groupe LLM de la section Addons :
- un fournisseur OpenAI Compatible LLM est intégré ; des fournisseurs personnalisés peuvent être téléversés en zip (bouton
Upload). Le manifeste de l’addon déclare les champs de configuration (clé API, URL de base, modèle, …) que l’interface Web transforme en formulaire ; - un fournisseur n’apparaît dans les sélecteurs de fonctions que tant que son addon est activé — activez-le d’abord dans la section Addons ;
- le bouton crayon sur une carte d’addon édite sa source ; un addon intégré modifié peut être restauré avec
Reset.
Configuration par fonction
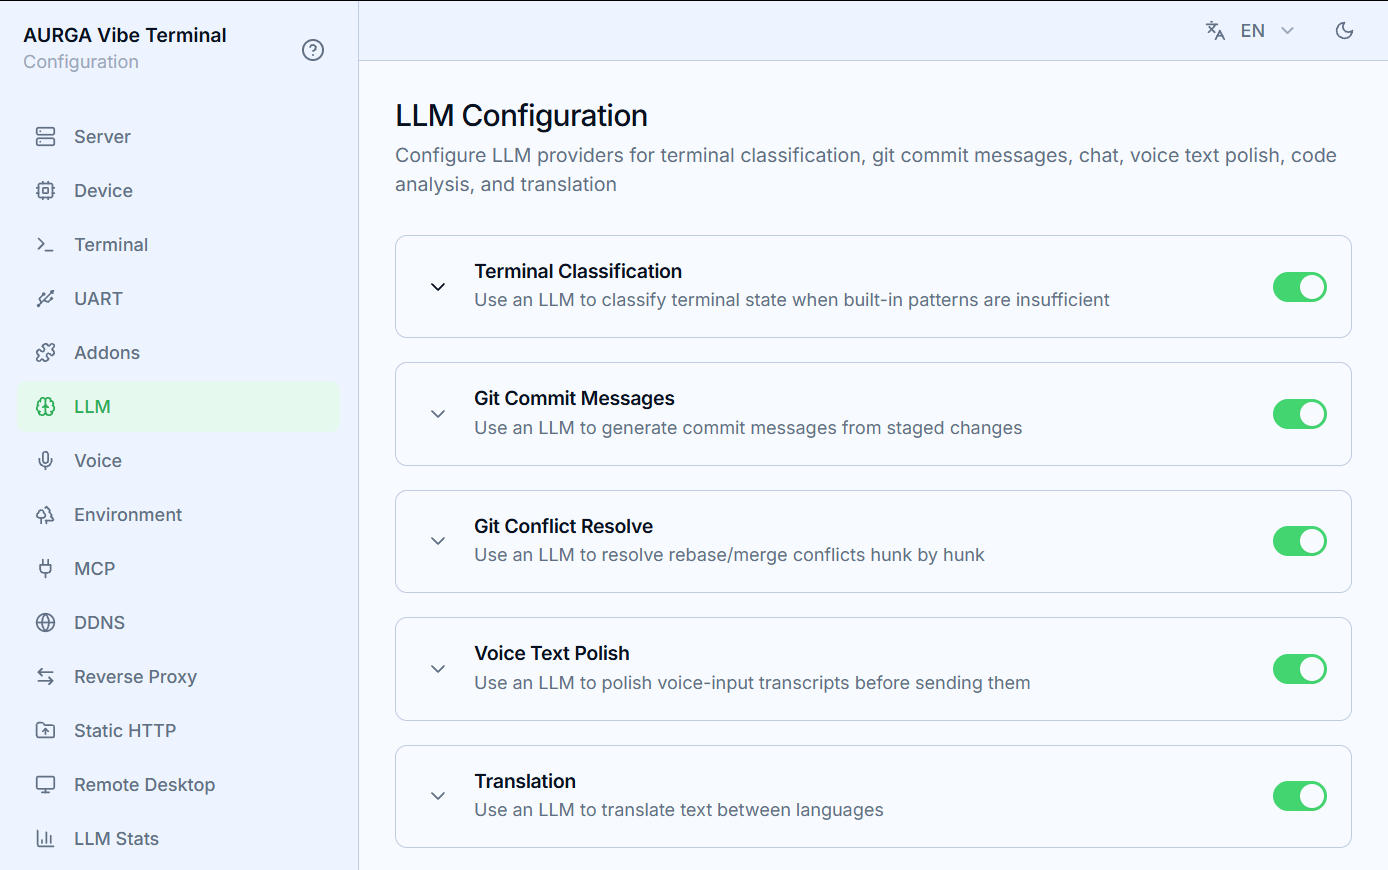
Chaque carte de fonction dans la section LLM a sa propre bascule d’activation et son propre choix de fournisseur, pour que différents travaux utilisent différents modèles :
- Terminal Classification — classifie l’état du terminal quand les motifs intégrés ne suffisent pas.
Max Consecutive Failuresdésactive le LLM pour la session après ce nombre d’échecs consécutifs (minimum 3) ; - Git Commit Messages — génère des messages de commit depuis les changements stagés ;
- Git Conflict Resolve — résout les conflits de rebase/fusion hunk par hunk ;
- Voice Text Polish — polit les transcriptions de saisie vocale avant l’envoi ;
- Translation — traduit le texte vers la langue cible choisie.
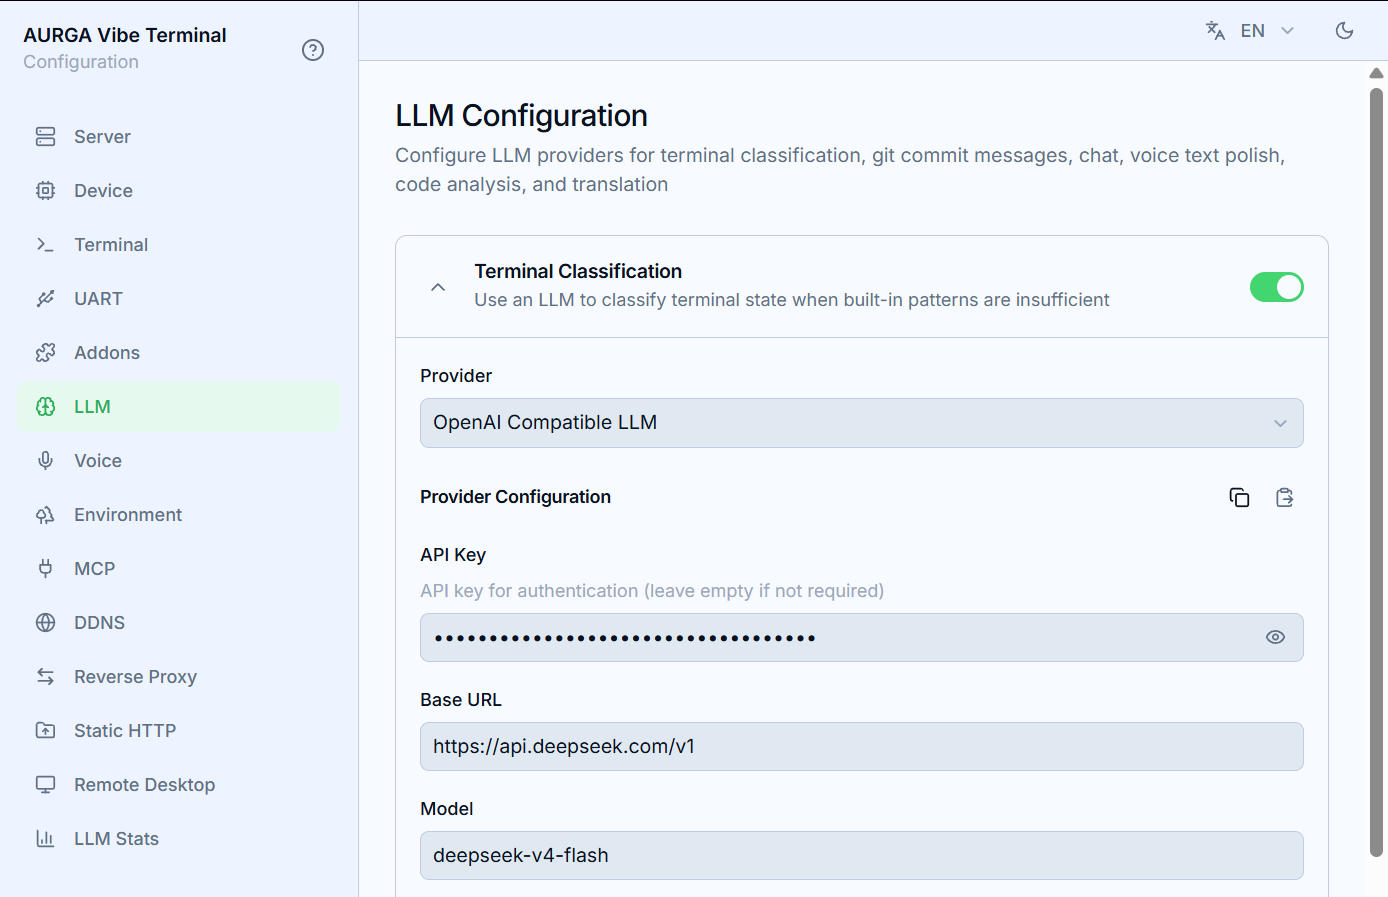
Dépliez une carte pour choisir son Provider et remplir les champs du fournisseur. La configuration est enregistrée même pendant que la fonction est désactivée et ne prend effet qu’une fois activée. Quand plusieurs fonctions utilisent le même addon fournisseur, les boutons copier/coller à côté de Provider Configuration permettent de cloner ses valeurs de champs entre elles (voir ci-dessous).
Les fonctions Terminal et Git offrent une langue de sortie avec option Auto (le modèle décide) ; la traduction utilise une liste cible explicite English/简体中文.
Copier/coller entre les fonctions
Chaque fonction conserve sa propre copie des champs du fournisseur, aussi utiliser un même fournisseur pour plusieurs fonctions implique normalement de retaper la même URL de base, la même clé API et le même modèle dans chaque carte. L’en-tête de Provider Configuration dispose de deux petits boutons qui évitent cette répétition :
- Copier — copie les valeurs de champs actuellement affichées dans cette carte, avec l’addon fournisseur auquel elles appartiennent ;
- Coller — apparaît dans une carte seulement si le fournisseur sélectionné y est le même addon que la configuration copiée ; un clic remplit les champs de la carte avec les valeurs copiées.
Pour partager un point de terminaison entre, disons, les messages de commit Git et la traduction : choisissez le fournisseur et remplissez ses champs dans la première carte, appuyez sur Copier, ouvrez l’autre carte (avec le même fournisseur sélectionné) et appuyez sur Coller. Les valeurs collées sont enregistrées dans la configuration propre à la fonction, comme toute autre modification de champ, et sont sauvegardées avec elle. Le presse-papiers est limité à la page — il est vidé lorsque vous quittez la section LLM.
Le fournisseur compatible OpenAI
Le fournisseur intégré fonctionne avec toute API de conversation compatible OpenAI. Champs clés :
Base URL/API Key/Model— point de terminaison, identifiants, nom du modèle ;Extra Body— un objet JSON fusionné dans chaque corps de requête, pour les paramètres spécifiques au modèle ;Max Input Tokens/Max Output Tokens— budget de prompt et plafond de complétion ;Timeout— délai par requête en secondes ; augmentez-le pour les modèles locaux lents.
Modèles recommandés
Ces tâches IA sont de petits prompts sensibles à la latence — un modèle rapide « juste ce qu’il faut » bat un grand modèle de raisonnement :
- Local : Qwen3.5 9B — le point idéal pour la génération de messages de commit Git, la classification de terminal, la traduction et le polissage vocal. Servez-le avec un point de terminaison compatible OpenAI (Ollama, vLLM, llama.cpp) et pointez
Base URLdessus ; - API : DeepSeek V4 Flash (
deepseek-v4-flash) — assez rapide pour un usage interactif et capable de gérer toutes les fonctions ci-dessus.
Le mode réflexion ajoute des secondes de latence et aide rarement ces tâches courtes — désactivez-le dans
Extra Bodypour une meilleure expérience, p. ex.{"enable_thinking": false}pour Qwen ou{"thinking": {"type": "disabled"}}pour DeepSeek (la clé exacte dépend de votre pile de service ; le JSON est fusionné tel quel dans le corps de requête).