Documentación
LLM
La sección LLM de la interfaz web asigna un proveedor LLM a cada función de IA — clasificación de terminal, mensajes de commit de Git, resolución de conflictos, pulido de texto de voz y traducción. Los proveedores mismos son addons de tipo LLM gestionados en la sección Addons.
Los proveedores son addons
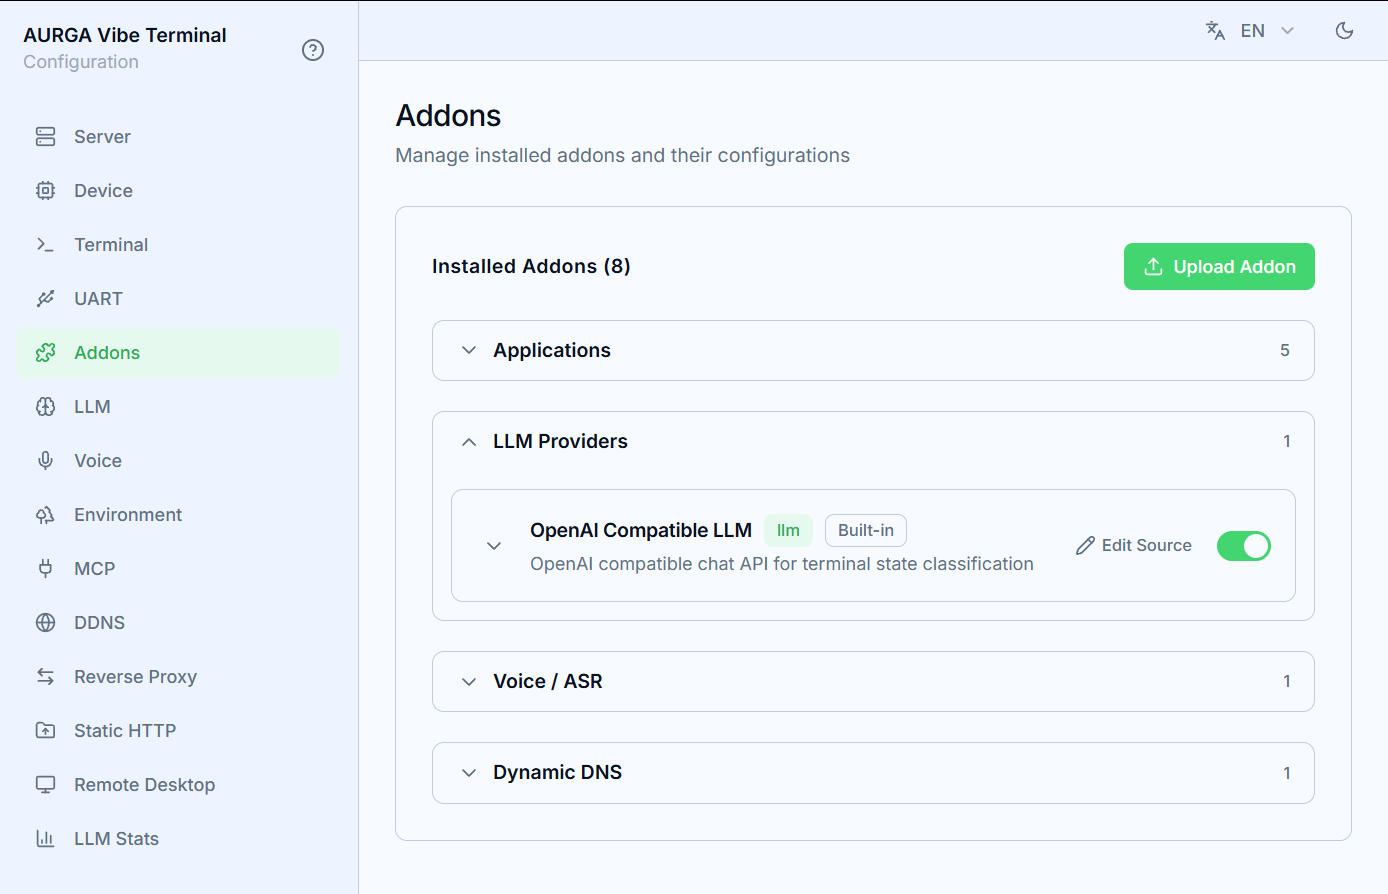
Los proveedores LLM viven en el grupo LLM de la sección Addons:
- un proveedor OpenAI Compatible LLM viene integrado; los proveedores personalizados pueden subirse como zip (botón
Upload). El manifiesto del addon declara los campos de configuración (clave de API, URL base, modelo, …) que la interfaz web convierte en formulario; - un proveedor solo aparece en los selectores de funciones mientras su addon está habilitado — actívalo primero en la sección Addons;
- el botón lápiz de una tarjeta de addon edita su fuente; un addon integrado que hayas modificado puede revertirse con
Reset.
Configuración por función
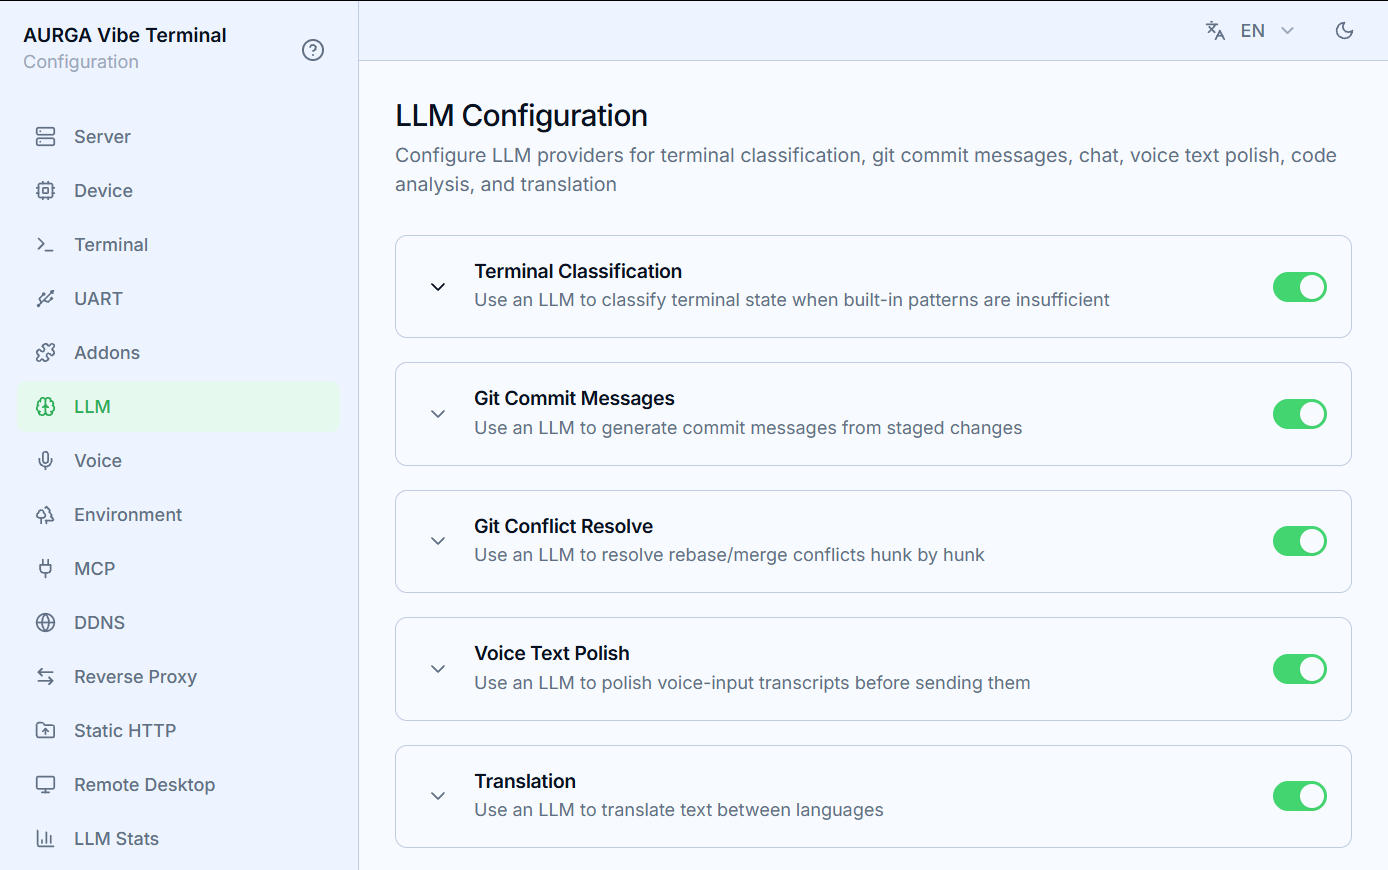
Cada tarjeta de función de la sección LLM tiene su propio conmutador de habilitación y su propia elección de proveedor, para que distintos trabajos usen distintos modelos:
- Terminal Classification — clasifica el estado del terminal cuando los patrones integrados no bastan.
Max Consecutive Failuresdeshabilita el LLM para la sesión tras ese número de fallos consecutivos (mínimo 3); - Git Commit Messages — genera mensajes de commit a partir de los cambios staged;
- Git Conflict Resolve — resuelve conflictos de rebase/fusión hunk a hunk;
- Voice Text Polish — pule las transcripciones de entrada de voz antes de enviarlas;
- Translation — traduce texto al idioma destino elegido.
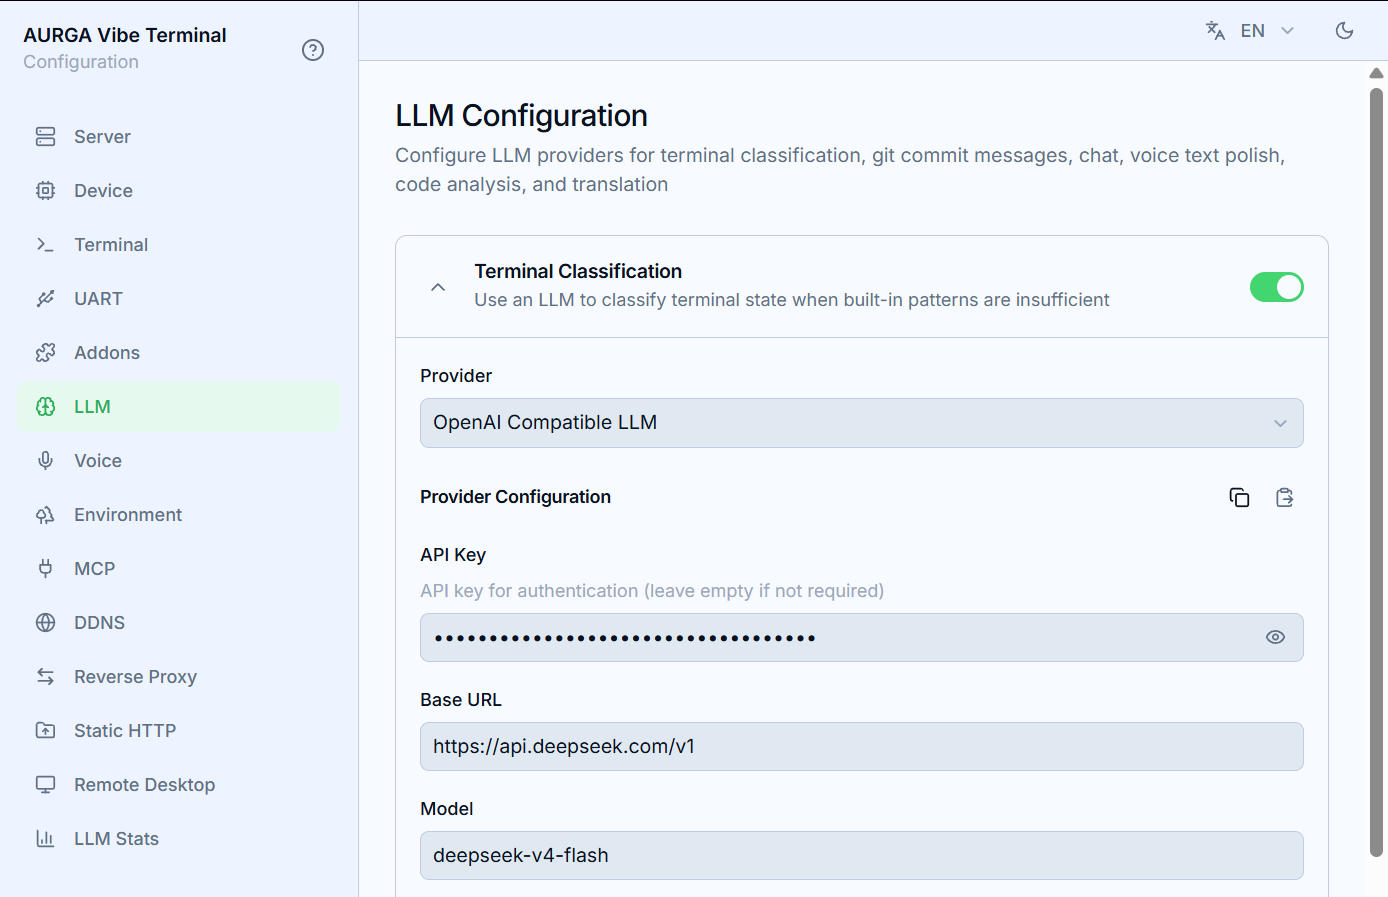
Despliega una tarjeta para elegir su Provider y rellenar los campos del proveedor. La configuración se guarda incluso con la función deshabilitada y solo surte efecto al habilitarse. Cuando varias funciones usan el mismo addon de proveedor, los botones copiar/pegar junto a Provider Configuration permiten clonar sus valores de campos entre ellas (ver abajo).
Las funciones de Terminal y Git ofrecen un idioma de salida con opción Auto (el modelo decide); la traducción usa una lista explícita de destinos English/简体中文.
Copiar/pegar entre funciones
Cada función guarda su propia copia de los campos del proveedor, así que usar un proveedor en varias funciones suele implicar reescribir la misma URL base, clave de API y modelo en cada tarjeta. El encabezado de Provider Configuration tiene dos botones pequeños que eliminan la repetición:
- Copiar — copia los valores de los campos mostrados actualmente en esta tarjeta, junto con el addon de proveedor al que pertenecen;
- Pegar — aparece en una tarjeta solo cuando el proveedor seleccionado en ella es el mismo addon que la configuración copiada; al pulsarlo rellena los campos de la tarjeta con los valores copiados.
Para compartir un punto de acceso entre, por ejemplo, los mensajes de commit de Git y la traducción: elige el proveedor y rellena sus campos en la primera tarjeta, pulsa Copiar, abre la otra tarjeta (con el mismo proveedor seleccionado) y pulsa Pegar. Los valores pegados se guardan en la configuración propia de esa función como cualquier otra edición de campos y se almacenan con ella. El portapapeles es solo de la página — se vacía al salir de la sección LLM.
El proveedor compatible con OpenAI
El proveedor integrado funciona con cualquier API de chat compatible con OpenAI. Campos clave:
Base URL/API Key/Model— punto de acceso, credenciales, nombre del modelo;Extra Body— un objeto JSON fusionado en cada cuerpo de petición, para parámetros específicos del modelo;Max Input Tokens/Max Output Tokens— presupuesto de prompt y tope de completado;Timeout— tiempo límite por petición en segundos; súbelo para modelos locales lentos.
Modelos recomendados
Estos trabajos de IA son prompts pequeños y sensibles a la latencia — un modelo rápido «en su punto» vence a un modelo grande de razonamiento:
- Local: Qwen3.5 9B — el punto dulce para generación de mensajes de commit de Git, clasificación de terminal, traducción y pulido de voz. Sirvelo con un punto de acceso compatible OpenAI (Ollama, vLLM, llama.cpp) y apunta
Base URLhacia él; - API: DeepSeek V4 Flash (
deepseek-v4-flash) — bastante rápido para uso interactivo y capaz de cubrir todas las funciones anteriores.
El modo de pensamiento añade segundos de latencia y rara vez ayuda en estas tareas cortas — desactívalo en
Extra Bodypara una mejor experiencia, p. ej.{"enable_thinking": false}para Qwen o{"thinking": {"type": "disabled"}}para DeepSeek (la clave exacta depende de tu pila de servicio; el JSON se fusiona literalmente en el cuerpo de la petición).