Dokumentation
LLM
Der Bereich LLM der Web UI weist jeder KI-Funktion einen LLM-Provider zu — Terminal-Klassifizierung, Git-Commit-Meldungen, Konfliktlösung, Sprachtext-Politur und Übersetzung. Provider selbst sind Addons vom Typ LLM, verwaltet im Bereich Addons.
Provider sind Addons
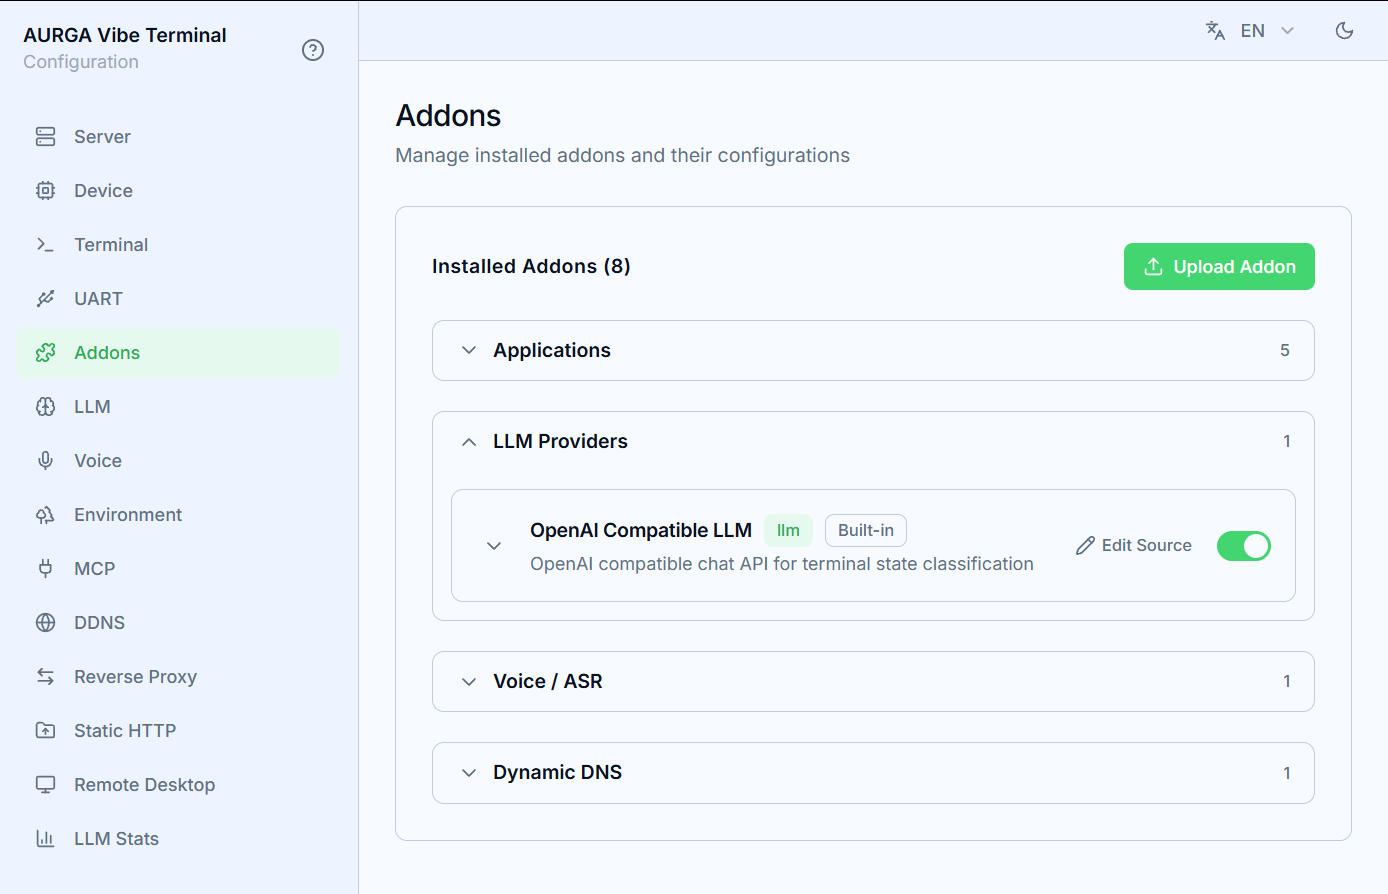
LLM-Provider leben in der Gruppe LLM des Bereichs Addons:
- Ein OpenAI Compatible LLM-Provider ist eingebaut; eigene Provider lassen sich als Zip hochladen (
Upload-Button). Das Addon-Manifest deklariert die Konfigurationsfelder (API-Schlüssel, Base-URL, Modell, …), die die Web UI in ein Formular verwandelt; - Ein Provider erscheint nur in den Funktionswählern, solange sein Addon aktiviert ist — schalten Sie es zuerst im Addons-Bereich ein;
- Mit dem Stift-Button auf einer Addon-Karte bearbeiten Sie seine Quelle; ein verändertes eingebautes Addon lässt sich mit
Resetzurückrollen.
Konfiguration je Funktion
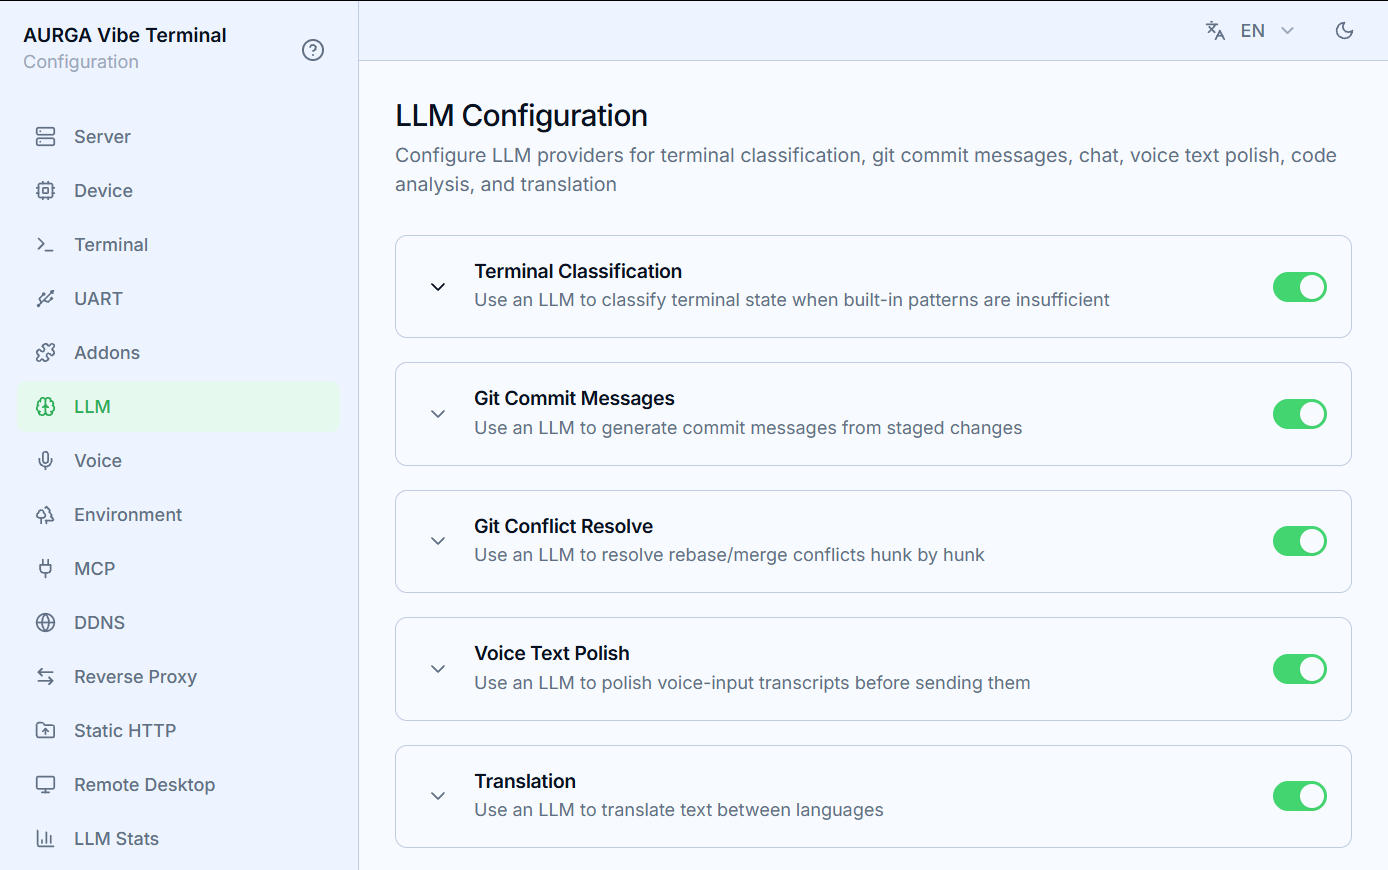
Jede Funktionskarte im Bereich LLM hat ihren eigenen Aktivierungsschalter und ihre eigene Providerwahl, sodass verschiedene Jobs verschiedene Modelle nutzen können:
- Terminal Classification — klassifiziert den Terminal-Zustand, wenn eingebaute Muster nicht reichen.
Max Consecutive Failuresdeaktiviert das LLM für die Sitzung nach so vielen Fehlversuchen (minimum 3); - Git Commit Messages — erzeugt Commit-Meldungen aus gestagten Änderungen;
- Git Conflict Resolve — löst Rebase-/Merge-Konflikte Hunk für Hunk;
- Voice Text Polish — poliert Spracheingabe-Transkripte vor dem Senden;
- Translation — übersetzt Text in die gewählte Zielsprache.
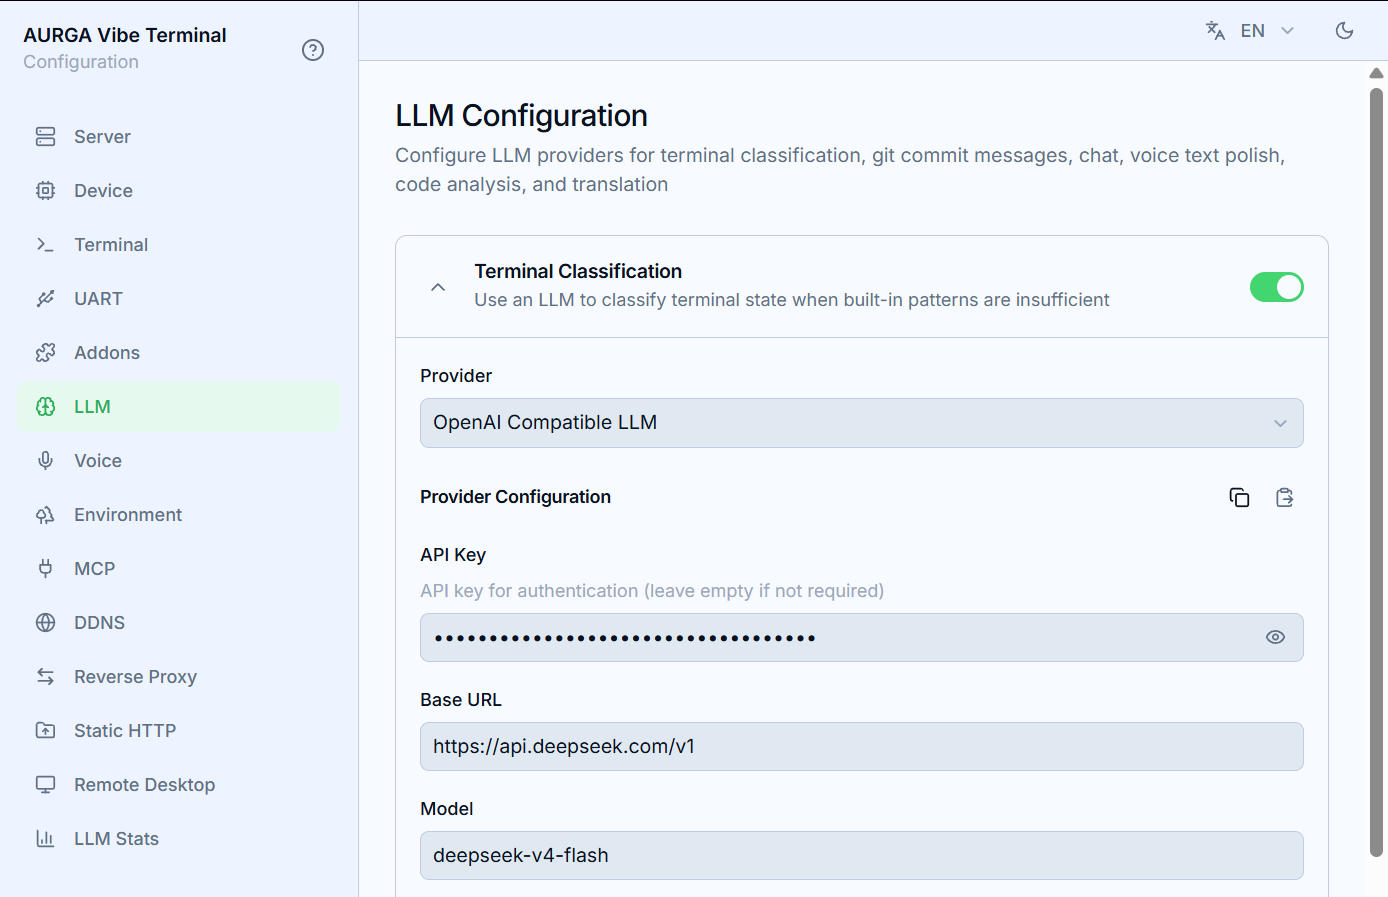
Klappen Sie eine Karte auf, um ihren Provider zu wählen und die Felder des Providers zu füllen. Die Konfiguration wird auch im deaktivierten Zustand gespeichert und wirkt erst nach dem Aktivieren. Wenn mehrere Funktionen dasselbe Provider-Addon nutzen, klonen die Kopieren-/Einfügen-Buttons neben Provider Configuration dessen Feldwerte zwischen ihnen (siehe unten).
Terminal- und Git-Funktionen bieten eine Ausgabesprache mit Auto-Option (das Modell entscheidet); die Übersetzung nutzt eine explizite English/简体中文-Zielliste.
Kopieren/Einfügen zwischen Funktionen
Jede Funktion bewahrt eine eigene Kopie der Provider-Felder, daher bedeutet ein Provider für mehrere Funktionen normalerweise, dieselbe Base-URL, denselben API-Schlüssel und dasselbe Modell in jeder Karte erneut einzutippen. Die Kopfzeile von Provider Configuration hat zwei kleine Buttons, die den Aufwand ersparen:
- Kopieren — kopiert die Feldwerte, die aktuell in dieser Karte angezeigt werden, zusammen mit dem Provider-Addon, dem sie gehören;
- Einfügen — erscheint in einer Karte nur, wenn dort derselbe Addon wie die kopierte Konfiguration ausgewählt ist; ein Klick füllt die Felder der Karte mit den kopierten Werten.
Um z. B. einen Endpunkt zwischen Git-Commit-Meldungen und Übersetzung zu teilen: Wählen Sie in der ersten Karte den Provider, füllen Sie die Felder aus, drücken Sie Kopieren, öffnen Sie die andere Karte (mit demselben Provider) und drücken Sie Einfügen. Die eingefügten Werte werden wie jede andere Feldänderung in der eigenen Konfiguration der Funktion gespeichert und mit ihr übernommen. Die Zwischenablage gilt nur innerhalb der Seite — sie wird geleert, wenn Sie den LLM-Bereich verlassen.
Der OpenAI-kompatible Provider
Der eingebaute Provider arbeitet mit jeder OpenAI-kompatiblen Chat-API. Zentrale Felder:
Base URL/API Key/Model— Endpunkt, Zugangsdaten, Modellname;Extra Body— ein JSON-Objekt, das in jeden Anfragekörper gemischt wird, für modellspezifische Parameter;Max Input Tokens/Max Output Tokens— Prompt-Budget und Abschluss-Deckel;Timeout— Zeitlimit pro Anfrage in Sekunden; erhöhen Sie es für langsame lokale Modelle.
Empfohlene Modelle
Diese KI-Aufgaben sind kleine, latenzempfindliche Prompts — ein schnelles „genau richtig“-Modell schlägt ein großes Reasoning-Modell:
- Lokal: Qwen3.5 9B — der Süßpunkt für Git-Commit-Meldungen, Terminal-Klassifizierung, Übersetzung und Sprachpolitur. Servieren Sie es mit einem OpenAI-kompatiblen Endpunkt (Ollama, vLLM, llama.cpp) und richten Sie
Base URLdarauf; - API: DeepSeek V4 Flash (
deepseek-v4-flash) — schnell genug für interaktive Nutzung und fähig, alle oben genannten Funktionen zu stemmen.
Denkmodus fügt Sekunden Latenz hinzu und hilft diesen kurzen Aufgaben selten — schalten Sie ihn für das bessere Erlebnis im
Extra Bodyab, z. B.{"enable_thinking": false}für Qwen oder{"thinking": {"type": "disabled"}}für DeepSeek (der exakte Schlüssel hängt vom Serving-Stack ab; das JSON wird unverändert in den Anfragekörper gemischt).