Documentação
LLM
A seção LLM da interface Web atribui um provedor LLM a cada recurso de IA — classificação de terminal, mensagens de commit do Git, resolução de conflitos, polimento de texto de voz e tradução. Os provedores mesmos são addons do tipo LLM gerenciados na seção Addons.
Provedores são addons
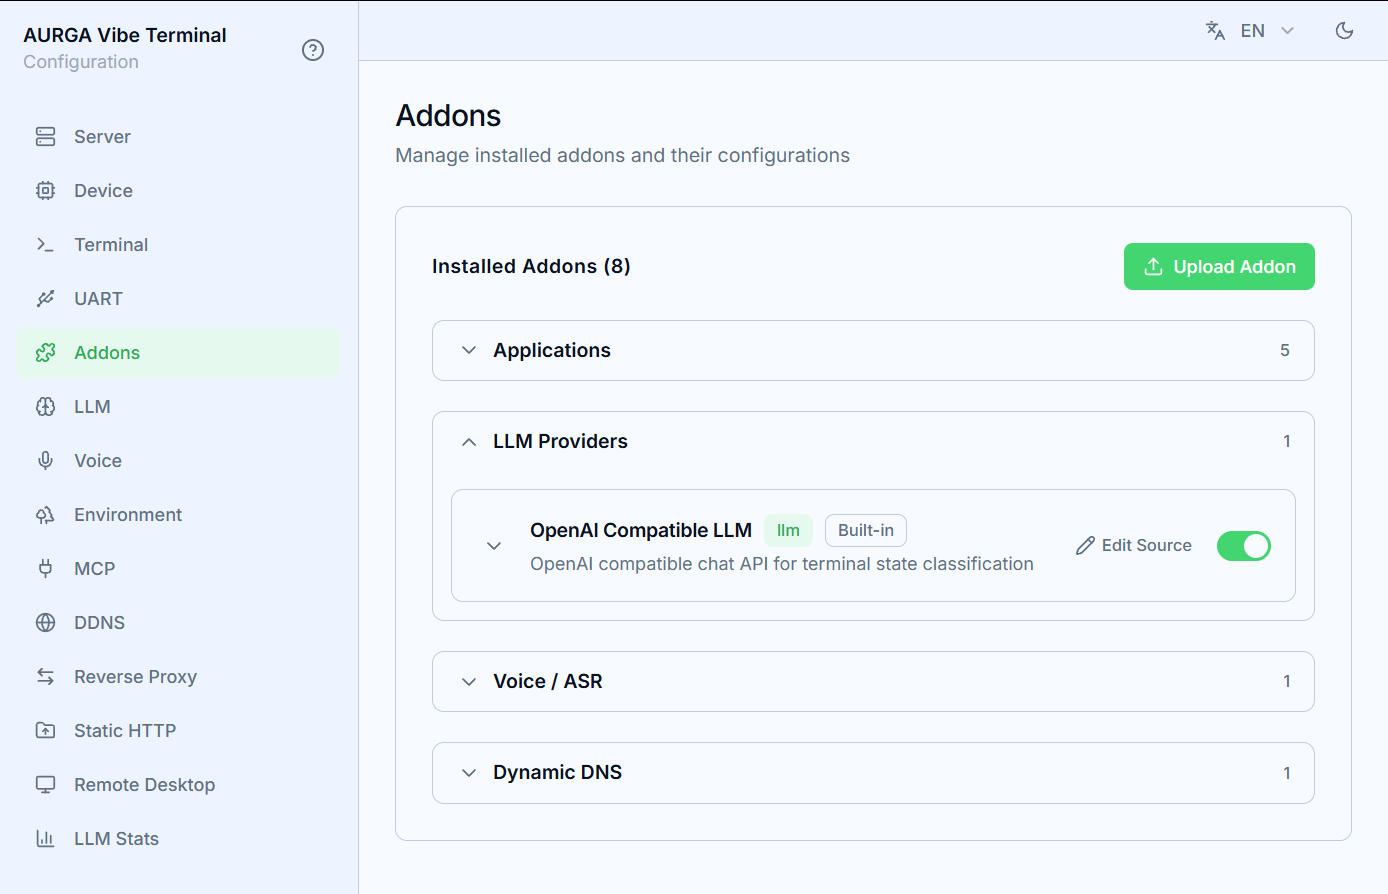
Provedores LLM vivem no grupo LLM da seção Addons:
- um provedor OpenAI Compatible LLM vem embutido; provedores personalizados podem ser enviados como zip (botão
Upload). O manifesto do addon declara os campos de configuração (chave de API, URL base, modelo, …) que a interface Web transforma num formulário; - um provedor só aparece nos seletores de recursos enquanto seu addon está habilitado — ligue-o primeiro na seção Addons;
- o botão lápis num cartão de addon edita sua fonte; um addon embutido que você modificou pode ser revertido com
Reset.
Configuração por recurso
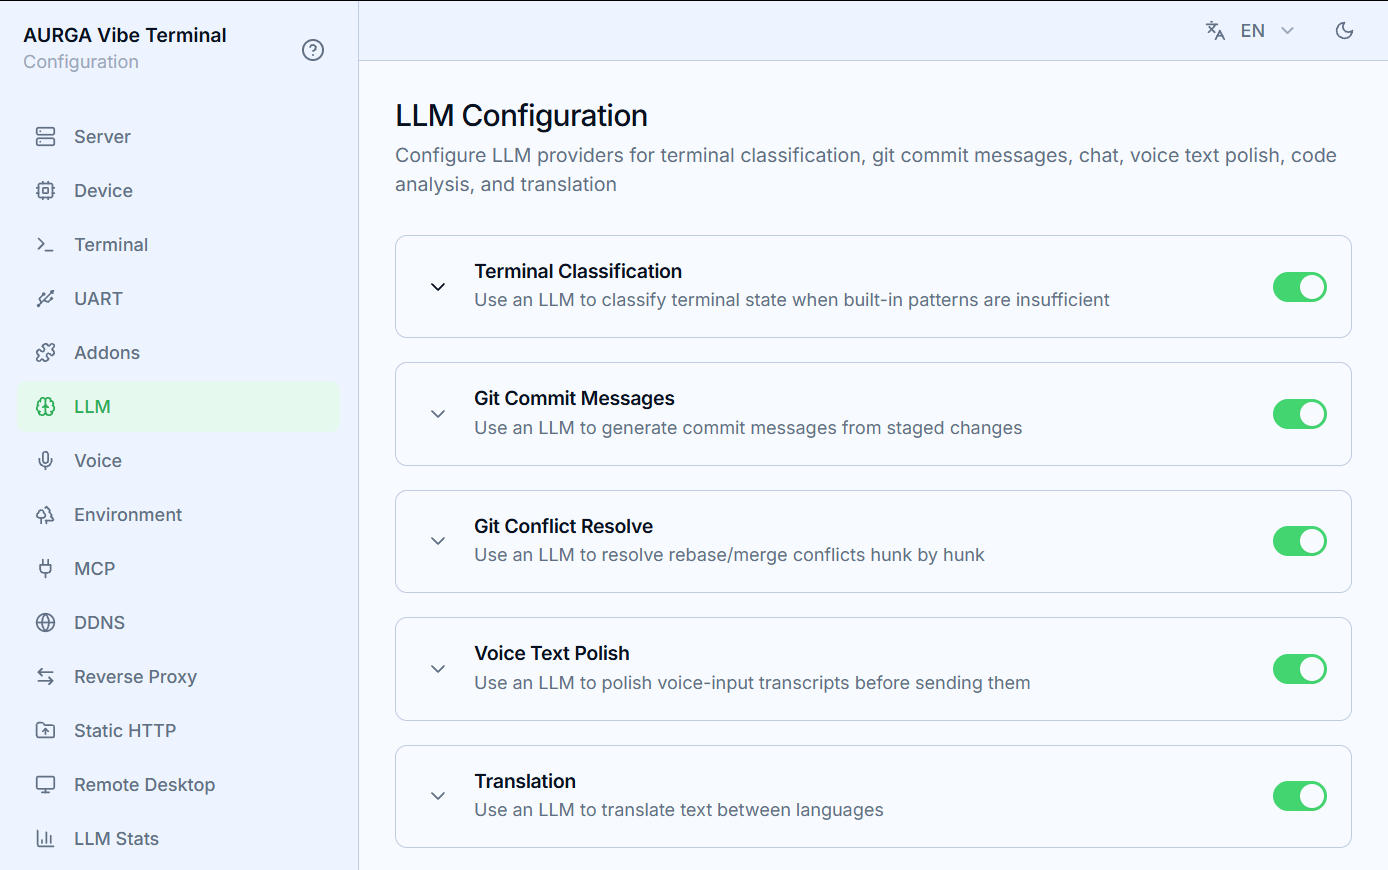
Cada cartão de recurso na seção LLM tem sua própria alternância de habilitação e sua própria escolha de provedor, para que trabalhos diferentes usem modelos diferentes:
- Terminal Classification — classifica o estado do terminal quando os padrões embutidos não bastam.
Max Consecutive Failuresdesabilita o LLM para a sessão após essa quantidade de falhas consecutivas (mínimo 3); - Git Commit Messages — gera mensagens de commit a partir das mudanças staged;
- Git Conflict Resolve — resolve conflitos de rebase/mesclagem hunk a hunk;
- Voice Text Polish — pole transcrições de entrada de voz antes do envio;
- Translation — traduz texto para o idioma alvo escolhido.
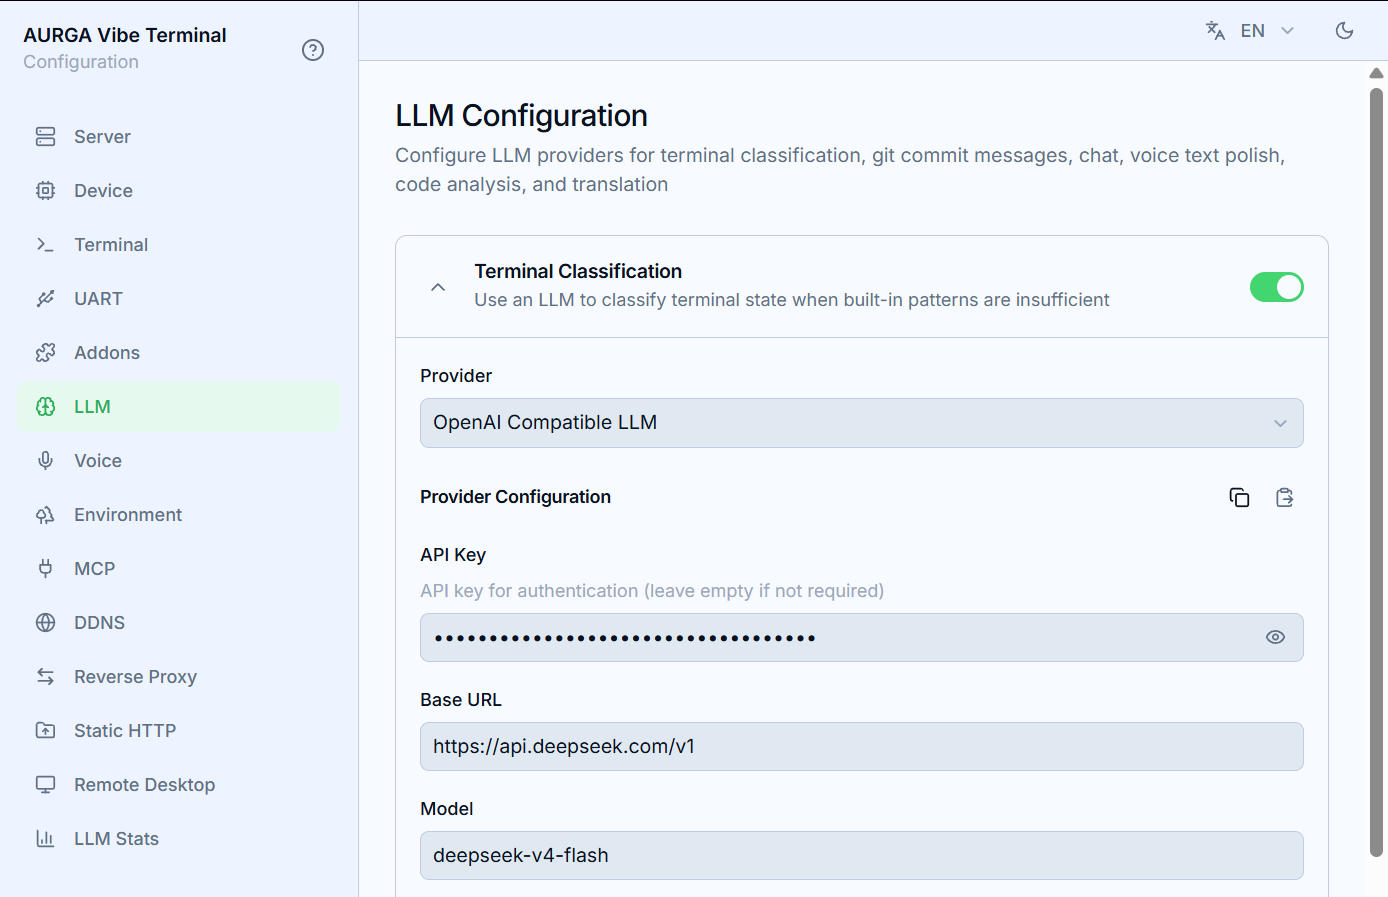
Expanda um cartão para escolher seu Provider e preencher os campos do provedor. A configuração é salva mesmo com o recurso desabilitado e só faz efeito uma vez habilitado. Quando vários recursos usam o mesmo addon de provedor, os botões copiar/colar ao lado de Provider Configuration permitem clonar seus valores de campos entre eles (veja abaixo).
Os recursos de Terminal e Git oferecem um idioma de saída com opção Auto (o modelo decide); a tradução usa uma lista explícita de alvos English/简体中文.
Copiar/colar entre recursos
Cada recurso guarda sua própria cópia dos campos do provedor, então usar um provedor em vários recursos normalmente significa reescrever a mesma URL base, chave de API e modelo em cada cartão. O cabeçalho de Provider Configuration tem dois botões pequenos que eliminam a repetição:
- Copiar — copia os valores de campos atualmente mostrados neste cartão, junto com o addon de provedor ao qual pertencem;
- Colar — aparece num cartão somente quando o provedor selecionado nele é o mesmo addon da configuração copiada; ao pressioná-lo, preenche os campos do cartão com os valores copiados.
Para compartilhar um endpoint entre, por exemplo, as mensagens de commit do Git e a tradução: escolha o provedor e preencha seus campos no primeiro cartão, pressione Copiar, abra o outro cartão (com o mesmo provedor selecionado) e pressione Colar. Os valores colados são armazenados na configuração própria daquele recurso, como qualquer outra edição de campo, e são salvos com ela. A área de transferência é só da página — ela é limpa ao sair da seção LLM.
O provedor compatível com OpenAI
O provedor embutido funciona com qualquer API de chat compatível com OpenAI. Campos-chave:
Base URL/API Key/Model— endpoint, credenciais, nome do modelo;Extra Body— um objeto JSON mesclado em cada corpo de requisição, para parâmetros específicos do modelo;Max Input Tokens/Max Output Tokens— orçamento de prompt e teto de conclusão;Timeout— tempo limite por requisição em segundos; aumente para modelos locais lentos.
Modelos recomendados
Esses trabalhos de IA são prompts pequenos e sensíveis à latência — um modelo rápido «na medida» vence um modelo grande de raciocínio:
- Local: Qwen3.5 9B — o ponto ideal para geração de mensagens de commit do Git, classificação de terminal, tradução e polimento de voz. Sirva-o com um endpoint compatível com OpenAI (Ollama, vLLM, llama.cpp) e aponte
Base URLpara ele; - API: DeepSeek V4 Flash (
deepseek-v4-flash) — rápido o bastante para uso interativo e capaz de cobrir todos os recursos acima.
O modo de pensamento adiciona segundos de latência e raramente ajuda nessas tarefas curtas — desligue-o no
Extra Bodypara uma experiência melhor, p. ex.{"enable_thinking": false}para Qwen ou{"thinking": {"type": "disabled"}}para DeepSeek (a chave exata depende da sua pilha de servir; o JSON é mesclado literalmente no corpo da requisição).