ドキュメント
LLM
Web UI の LLM セクションは、各 AI 機能 — ターミナル分類、Git コミットメッセージ、競合解決、音声テキストのポリッシュ、翻訳 — に LLM プロバイダーを割り当てます。プロバイダー自体は Addons セクションで管理される LLM タイプのアドオンです。
プロバイダーはアドオン
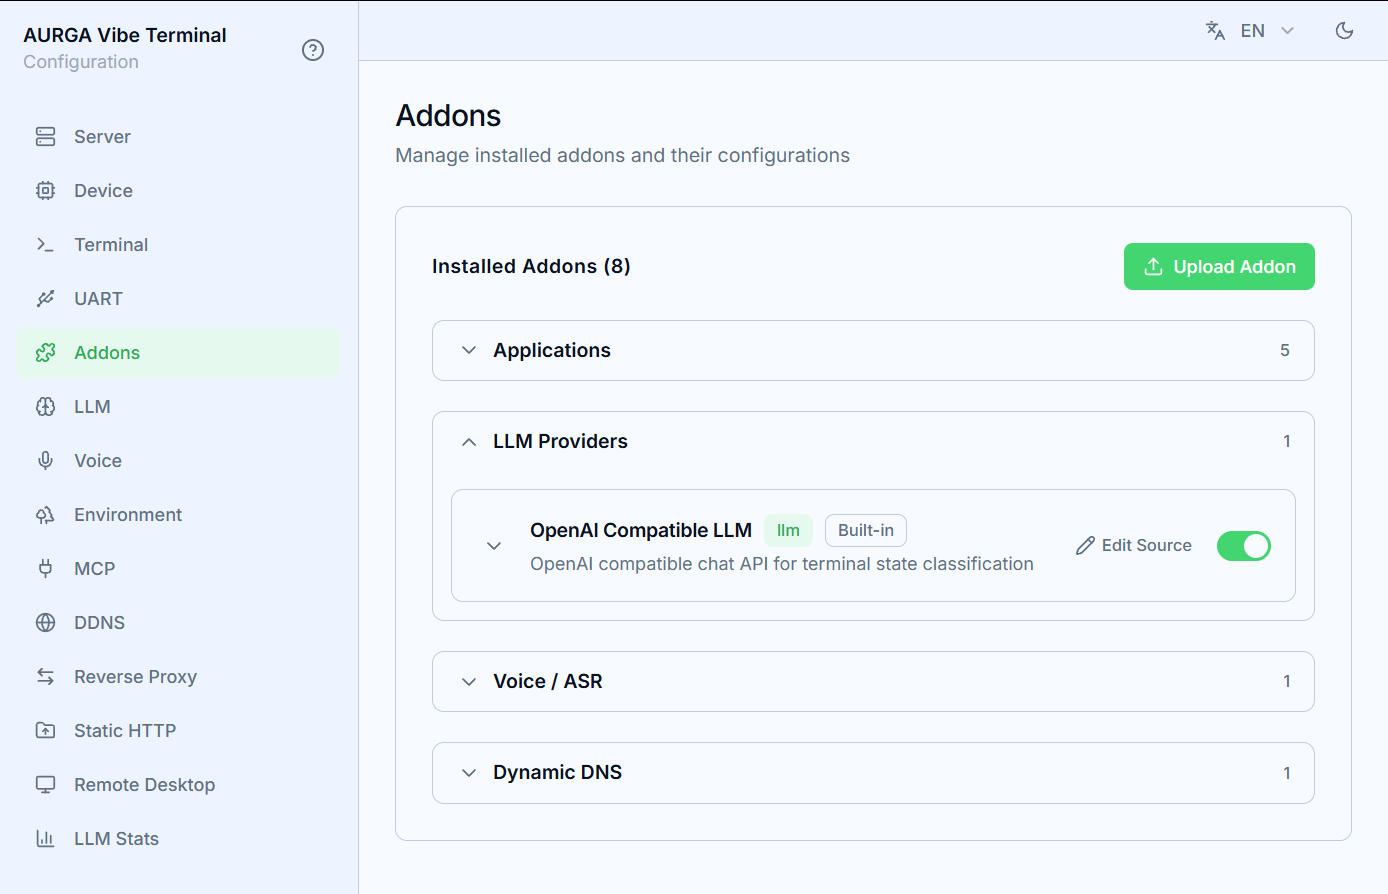
LLM プロバイダーは Addons セクションの LLM グループにあります:
- OpenAI Compatible LLM プロバイダーが内蔵されています。カスタムプロバイダーは zip としてアップロードできます(
Uploadボタン)。アドオンのマニフェストが設定フィールド(API キー、ベース URL、モデルなど)を宣言し、Web UI がフォームに変換します; - プロバイダーはアドオンが有効な間だけ機能ピッカーに現れます — まず Addons セクションでオンにしてください;
- アドオンカードの鉛筆ボタンでソースを編集できます。変更した内蔵アドオンは
Resetでロールバックできます。
機能ごとの設定
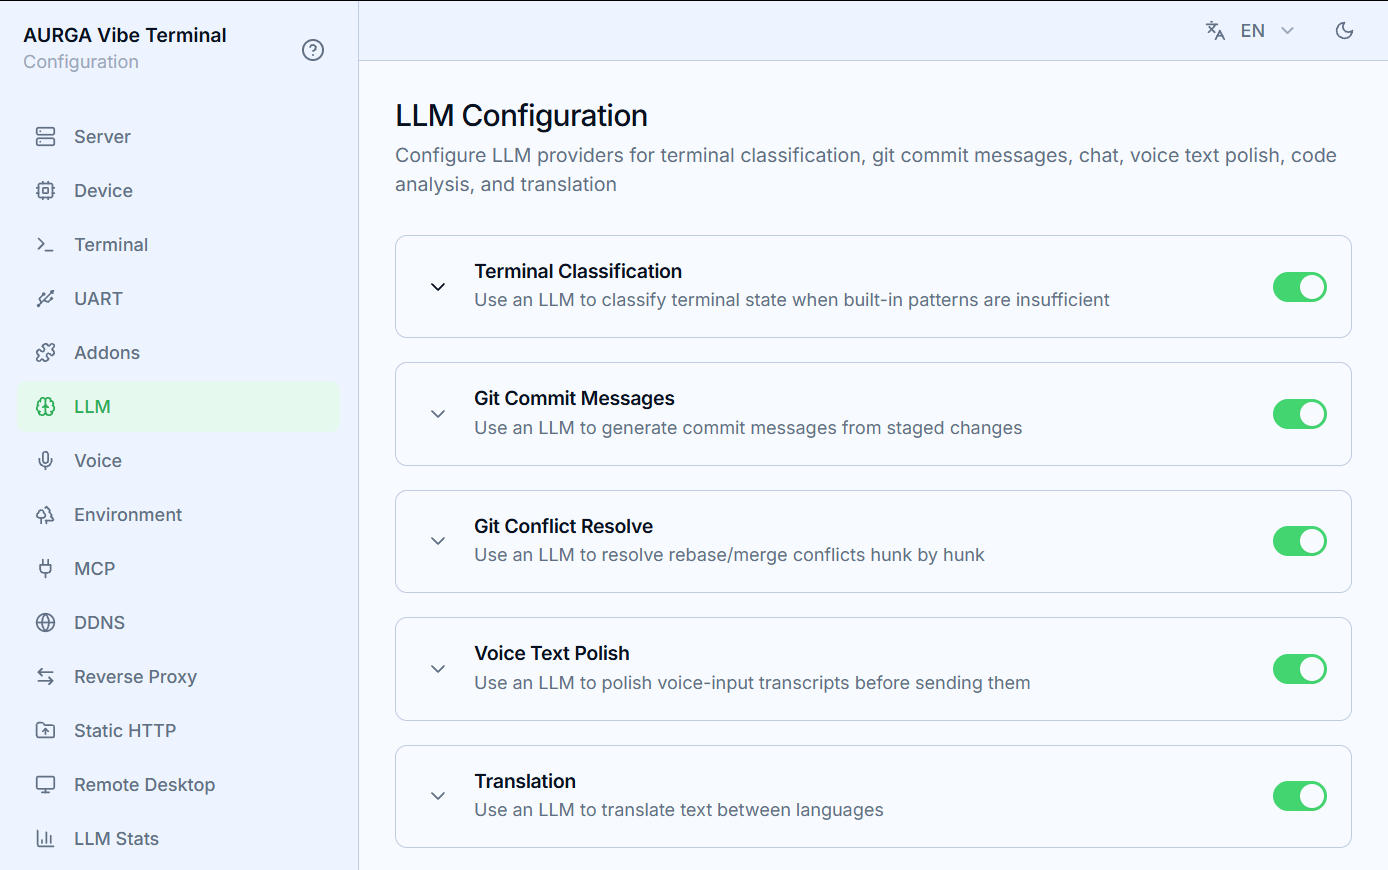
LLM セクションの各機能カードは独自の有効トグルとプロバイダー選択を持つため、異なる仕事に異なるモデルを使えます:
- Terminal Classification — 内蔵パターンで不足するときにターミナル状態を分類します。
Max Consecutive Failuresは、その回数連続失敗したらセッションの LLM を無効化します(最小 3); - Git Commit Messages — ステージされた変更からコミットメッセージを生成;
- Git Conflict Resolve — リベース/マージの競合をハンクごとに解決;
- Voice Text Polish — 送信前に音声入力の文字起こしをポリッシュ;
- Translation — テキストを選択したターゲット言語に翻訳。
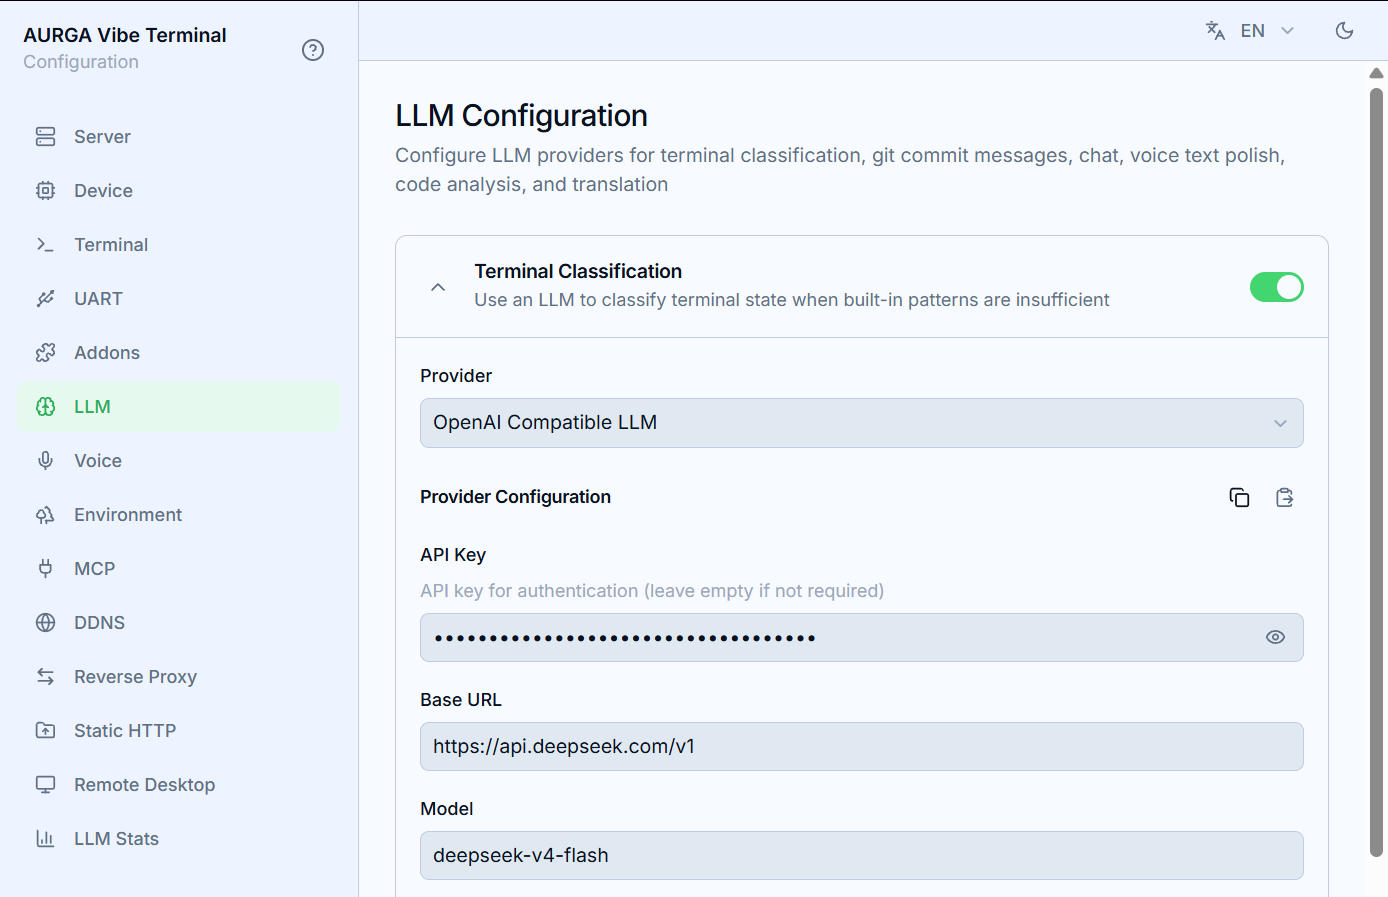
カードを展開して Provider を選び、プロバイダーのフィールドを入力します。設定は機能が無効の間も保存され、有効化された時点で効果を持ちます。複数の機能が同じプロバイダーアドオンを使う場合、Provider Configuration 横のコピー/ペーストボタンでそのフィールド値を機能間で複製できます(下記参照)。
ターミナルと Git 機能には Auto オプション付きの出力言語(モデルが決定)があります。翻訳は明示的な English/簡体中文 ターゲットリストを使います。
機能間のコピー/ペースト
各機能はプロバイダーのフィールドの自分のコピーを保持するため、複数の機能で同じプロバイダーを使うと、通常は各カードで同じベース URL、API キー、モデルを再入力することになります。Provider Configuration の見出しには、この重複を省く 2 つの小さなボタンがあります:
- コピー — このカードに表示中のフィールド値を、その属するプロバイダーアドオンとともにコピーします;
- ペースト — カードで選択中のプロバイダーがコピーした設定と同一のアドオンの場合のみ表示されます。クリックするとコピーした値がそのカードのフィールドに入ります。
例えば Git コミットメッセージと翻訳で同じエンドポイントを共有するには: 最初のカードでプロバイダーを選びフィールドを入力し、コピーを押します。もう一方のカード(同じプロバイダーが選択されていること)を開いてペーストを押します。貼り付けられた値は他のフィールド編集と同様にその機能自身の設定に保存され、設定と一緒に保存されます。クリップボードはページ内のみ有効で、LLM セクションを離れるとクリアされます。
OpenAI 互換プロバイダー
内蔵プロバイダーは任意の OpenAI 互換チャット API で動作します。主なフィールド:
Base URL/API Key/Model— エンドポイント、認証情報、モデル名;Extra Body— 毎回のリクエストボディにマージされる JSON オブジェクト。モデル固有パラメータ用;Max Input Tokens/Max Output Tokens— プロンプト予算と完了上限;Timeout— リクエストごとのタイムアウト(秒)。遅いローカルモデルでは増やしてください。
推奨モデル
これらの AI 仕事は小さくレイテンシに敏感なプロンプトです。速い「ちょうど良い」モデルが大型の推論モデルに勝ります:
- ローカル: Qwen3.5 9B — Git コミットメッセージ生成、ターミナル分類、翻訳、音声ポリッシュのスイートスポット。OpenAI 互換エンドポイント(Ollama、vLLM、llama.cpp)で提供し、
Base URLを向けてください; - API: DeepSeek V4 Flash (
deepseek-v4-flash) — インタラクティブ使用に十分速く、上記すべての機能をこなせます。
思考モードは数秒のレイテンシを追加し、こうした短いタスクにはほとんど寄与しません —
Extra Bodyでオフにするのが良い体験です。例: Qwen は{"enable_thinking": false}、DeepSeek は{"thinking": {"type": "disabled"}}(正確なキーは提供スタック次第。JSON はリクエストボディにそのままマージされます)。